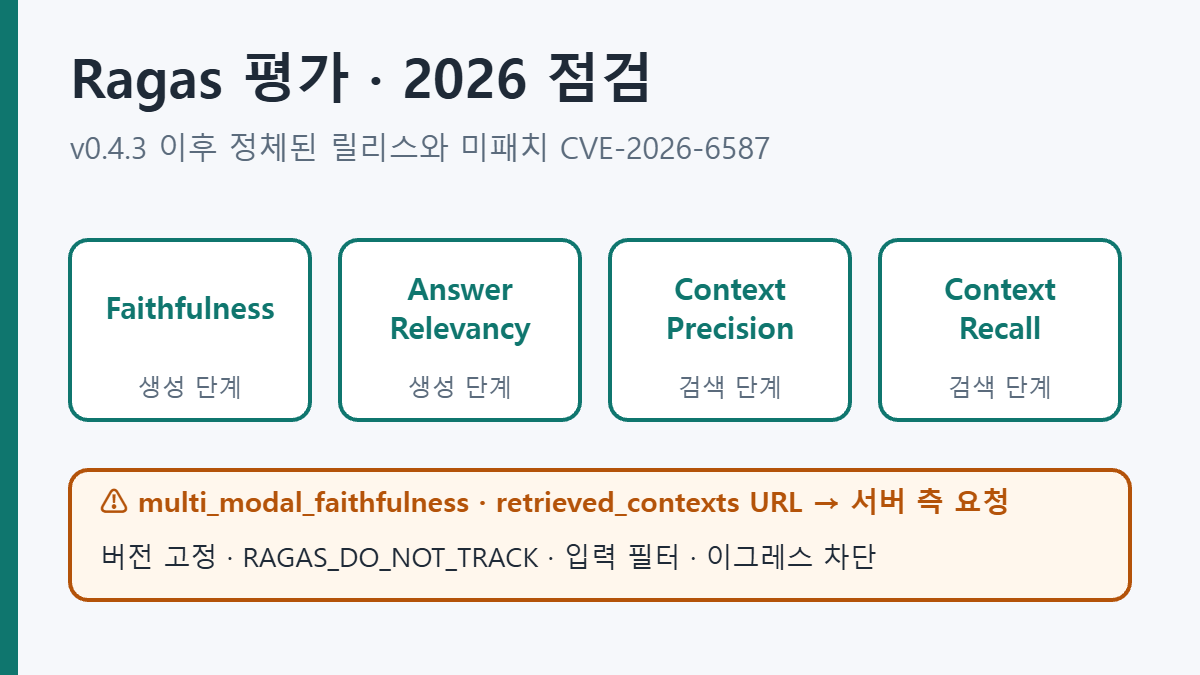
- Ragas는 2026년 1월 v0.4.3 이후 새 릴리스가 없고, 기존 지표 API는 제거 예고 상태로 남아 있다
- CVE-2026-6587은 멀티모달 Faithfulness의 retrieved_contexts URL 처리에서 생기는 미패치 SSRF다
- 버전 고정, RAGAS_DO_NOT_TRACK, 입력 필터, 지표 정의 문서화로 위험을 줄인 뒤 대안을 비교한다
사내 RAG를 PoC에서 운영으로 넘길 때 가장 먼저 받는 질문은 “답변 품질을 무엇으로 증명하나요?”입니다. 많은 팀이 이 질문에 Ragas 평가로 답해 왔습니다. 그런데 2026년 들어 Ragas는 릴리스가 0.4.3에서 멈췄고, 4월에는 패치가 나오지 않은 SSRF 취약점(CVE-2026-6587)까지 공개됐습니다. 이 글은 Ragas 평가가 무엇을 재는지 다시 짚고, 0.4.3 소스를 직접 열어 확인한 위험 지점과 지금 쓰는 팀이 할 일을 순서대로 정리합니다.
Ragas 평가가 측정하는 네 가지 지표
Ragas 평가는 정답 데이터 없이도 RAG 파이프라인을 채점하는 LLM 평가 방법입니다. 2023년 논문의 핵심은 사람이 쓴 모범 답안과 비교하는 대신, 심판 역할의 LLM이 답변의 성질을 직접 판단하게 한 점입니다. 검색 단계와 생성 단계를 나눠 볼 수 있어서 “검색이 틀렸는지, 생성이 틀렸는지”를 가르는 데 쓰입니다.
먼저 네 지표가 무엇을 입력으로 받고, 정답(reference)이 꼭 필요한지부터 보면 구분이 쉽습니다. 아래 클래스 이름은 0.4.3의 ragas.metrics.collections 기준입니다.
| 지표 | 보는 단계 | 필요한 입력 | 정답 필요 | 판정 방식 |
|---|---|---|---|---|
| Faithfulness | 생성 | 질문, 답변, 검색 문맥 | 아니오 | LLM이 주장 단위로 판정 |
| Answer Relevancy | 생성 | 질문, 답변 | 아니오 | LLM 역질문 생성 + 임베딩 유사도 |
| Context Precision | 검색 | 질문, 검색 문맥, 정답(또는 답변) | 선택 | LLM이 청크별 관련성 판정 후 순위 가중 |
| Context Recall | 검색 | 질문, 검색 문맥, 정답 | 예 | LLM이 정답 문장별 근거 여부 판정 |
이해를 돕기 위해 하나의 예시로 네 지표를 모두 계산해 보겠습니다. 사내 규정 RAG에 “출장비 정산 기한은 언제인가요?”라고 물었고, 정답은 “출장 종료 후 7일 이내에 정산하고, 영수증 원본을 제출한다”라고 가정합니다. 아래 숫자는 계산 방식을 보여 주기 위한 설명용 예시입니다.
Faithfulness: 답변이 검색 문맥에 충실한가
Faithfulness는 답변에 담긴 주장이 검색된 문맥으로 뒷받침되는 비율입니다. Ragas 평가에서 환각을 잡는 가장 직접적인 지표라서 운영 환경에서 제일 먼저 보는 값입니다.
- 심판 LLM이 답변을 더 쪼갤 수 없는 개별 주장으로 나눕니다.
- 각 주장이 검색 문맥에서 추론 가능한지 하나씩 판정합니다.
- Faithfulness = 문맥으로 뒷받침되는 주장 수 ÷ 전체 주장 수
예시 답변이 “출장 종료 후 7일 이내에 정산하며, 법인카드 사용분은 별도 증빙이 필요 없습니다”였다고 해 보겠습니다. 주장은 두 개입니다. 검색 문맥에 7일 규정은 있지만 법인카드 관련 내용이 없다면 점수는 1 ÷ 2 = 0.5입니다. 두 번째 주장은 사실일 수도 있지만, 문맥에 없으니 “충실하지 않다”로 처리됩니다.
- 낮을 때 의심할 곳: 모델이 사전 지식으로 빈칸을 채우는 경우, 문맥에 근거가 없을 때 “모른다”고 답하라는 지시가 약한 경우입니다.
- 주의점: 정답 여부가 아니라 문맥 충실도를 봅니다. 틀린 문서를 충실하게 옮겨도 점수는 높게 나옵니다. 그래서 검색 지표와 함께 읽어야 합니다.
Answer Relevancy: 답변이 질문에 맞게 답하는가
Answer Relevancy는 답변이 질문의 의도에 얼마나 맞는지를 봅니다. 사실 여부는 따지지 않고, 동문서답이나 불필요한 군더더기, 빠진 부분을 감점합니다.
- 심판 LLM이 답변만 보고 “이 답변이 나왔을 법한 질문”을 기본 3개 만듭니다. 개수는
strictness파라미터로 바꿉니다. - 원래 질문과 생성된 질문들을 임베딩한 뒤 코사인 유사도를 구합니다.
- Answer Relevancy = 생성 질문과 원래 질문 간 코사인 유사도의 평균
예시에서 답변이 “출장비는 경영지원팀이 담당하며, 출장 규정은 2025년에 개정됐습니다”였다면, 역으로 만든 질문은 “출장비 담당 부서는?”, “출장 규정은 언제 개정됐나?”에 가깝게 나옵니다. 원래 질문인 “정산 기한”과 거리가 멀어 점수가 낮아집니다. 0.4.3 구현은 답변이 “잘 모르겠습니다”처럼 회피성인지도 함께 판정해, 생성된 결과가 모두 회피성이면 0점을 줍니다.
- 낮을 때 의심할 곳: 검색 문맥에 엉뚱한 문서가 섞여 답변이 그쪽으로 끌려간 경우, 답변 형식 지시가 장황한 경우입니다.
- 주의점: 임베딩 모델 품질에 따라 점수가 흔들립니다. 코사인 유사도 특성상 이론적으로는 0~1을 벗어날 수 있고, 한국어 질문이라면 한국어를 잘 다루는 임베딩 모델을 써야 의미 있는 값이 나옵니다. 사내 비교 실험에서는 임베딩 모델을 고정해야 합니다.
Context Precision: 관련 청크가 위쪽에 놓였는가
Context Precision은 검색기가 관련 청크를 상위 순위에 올렸는지를 봅니다. 같은 청크를 가져왔더라도 관련 없는 청크가 맨 위에 있으면 점수가 떨어집니다. LLM은 앞쪽 문맥에 더 큰 영향을 받기 때문에 순위가 중요합니다.
- 심판 LLM이 검색된 청크 하나하나가 정답(또는 답변)을 만드는 데 쓸모 있는지 판정합니다(관련 1, 무관 0).
- 관련 청크가 나온 순위 k마다 Precision@k(상위 k개 중 관련 청크 비율)를 구합니다.
- Context Precision = 관련 청크 위치의 Precision@k 합 ÷ 관련 청크 수
예시에서 청크 3개가 [관련, 무관, 관련] 순서라면 Precision@1 = 1, Precision@3 = 2/3이므로 (1 + 0.67) ÷ 2 ≈ 0.83입니다. 같은 청크가 [무관, 관련, 관련] 순서라면 Precision@2 = 1/2, Precision@3 = 2/3이 되어 (0.5 + 0.67) ÷ 2 ≈ 0.58로 내려갑니다. 무관한 청크가 둘째 자리에 있을 때보다 첫째 자리에 있을 때 손해가 큽니다.
0.4.3에는 정답과 비교하는 ContextPrecisionWithReference와, 정답 없이 생성된 답변과 비교하는 ContextPrecisionWithoutReference가 따로 있습니다. 골든셋이 없는 초기에는 후자로 시작할 수 있지만, 답변이 틀리면 판정 기준도 같이 틀어진다는 한계가 있습니다.
- 낮을 때 의심할 곳: 리랭커(re-ranker, 검색 결과의 순위를 다시 매기는 모델)가 없거나 약한 경우, 하이브리드 검색에서 키워드와 벡터 결과를 합치는 가중치가 맞지 않는 경우입니다.
- 대응: 리랭커 도입, 상위 k 축소, 하이브리드 검색 가중치 조정이 효과가 바로 보이는 순서입니다.
Context Recall: 답에 필요한 정보를 빠짐없이 가져왔는가
Context Recall은 정답에 담긴 내용이 검색 문맥에 얼마나 들어 있는지를 봅니다. 네 지표 중 유일하게 정답이 반드시 필요합니다. 검색 단계에서 놓친 정보가 있는지 확인하는 지표입니다.
- 심판 LLM이 정답을 문장 단위로 나눕니다.
- 각 문장이 검색 문맥에서 근거를 찾을 수 있는지 판정합니다.
- Context Recall = 문맥에서 근거를 찾은 정답 문장 수 ÷ 정답 전체 문장 수
예시의 정답은 “7일 이내 정산”과 “영수증 원본 제출” 두 문장입니다. 검색 문맥에 7일 규정만 있고 원본 제출 조항이 없다면 1 ÷ 2 = 0.5입니다. 이 상태에서는 생성 모델이 아무리 좋아도 완전한 답을 낼 수 없습니다.
- 낮을 때 의심할 곳: 청크가 너무 작아 조항이 잘린 경우, 표나 첨부 문서가 적재 단계에서 빠진 경우, 임베딩 모델이 사내 용어를 잘 못 잡는 경우입니다.
- 대응: 청킹 크기와 겹침 조정, 표·첨부 파싱 점검, 상위 k 확대, 임베딩 모델 교체 순으로 봅니다. 상위 k를 늘리면 Recall은 오르지만 Precision은 떨어지기 쉬우므로 두 값을 함께 봐야 합니다.
네 지표를 함께 읽는 법
Ragas 평가 결과는 지표 하나만 보면 원인을 잘못 짚기 쉽습니다. 실무에서는 아래처럼 조합으로 읽습니다.
| 증상 | 가능성이 높은 원인 | 먼저 손볼 곳 |
|---|---|---|
| Context Recall 낮음 | 필요한 문서를 못 가져옴 | 청킹, 적재 누락, 임베딩, 상위 k |
| Recall은 높고 Precision 낮음 | 가져오긴 했지만 순위가 나쁨 | 리랭커, 하이브리드 가중치 |
| 검색 지표는 높고 Faithfulness 낮음 | 생성 모델이 문맥 밖 내용을 덧붙임 | 시스템 프롬프트, 근거 인용 강제, 모델 |
| Faithfulness는 높고 Answer Relevancy 낮음 | 문맥은 지켰지만 질문에 맞게 답하지 않음 | 답변 형식 지시, 질문 재작성 단계 |
네 지표 모두 심판 LLM의 판단에 기대므로, 같은 데이터를 두 번 돌려도 값이 조금씩 달라질 수 있습니다. 심판 모델과 임베딩 모델, 프롬프트 버전을 고정하고, 소수점 둘째 자리 차이보다는 추세와 구간을 보는 편이 안전합니다. 검색 구조 자체는 Advanced RAG 아키텍처 정리에서 다뤘습니다.
2026년 Ragas 프로젝트 상태: 0.4.3 이후 멈춘 릴리스
마지막 릴리스는 2026년 1월 13일의 v0.4.3입니다. 이후 main 브랜치 커밋은 2월 24일이 마지막으로 확인됩니다. 저장소는 vibrantlabsai 조직으로 옮겨졌고, 기존 explodinggradients 주소는 그쪽으로 넘어갑니다.
도구가 멈췄다고 바로 못 쓰는 것은 아닙니다. 다만 운영 관점에서 세 가지가 걸립니다.
- API 전환이 반쯤 걸려 있습니다. 0.4.3에서
ragas.metrics의 기존 지표 클래스는 여전히 동작하지만, 불러올 때마다 v1.0에서 제거된다는 경고가 뜹니다. 새 경로는ragas.metrics.collections인데, v1.0은 나오지 않았습니다. - 보안 수정이 들어올 경로가 없습니다. 아래 CVE를 고치려던 외부 PR도 병합되지 않았다는 보도가 있습니다.
- 새 심판 모델 대응이 늦어집니다. 프롬프트 템플릿과 클라이언트 래퍼는 라이브러리에 묶여 있습니다.
비교 대상도 움직였습니다. DeepEval은 10월에 v4.3.1까지 나왔고, Giskard는 8월 v3.0.0에서 패키지를 나눈 전면 재작성을 했습니다. 갈아탈 후보는 있지만, 어느 쪽도 그대로 끼워 넣을 수 있는 대체품은 아닙니다.
CVE-2026-6587, Ragas 평가 파이프라인에서 위험한 지점
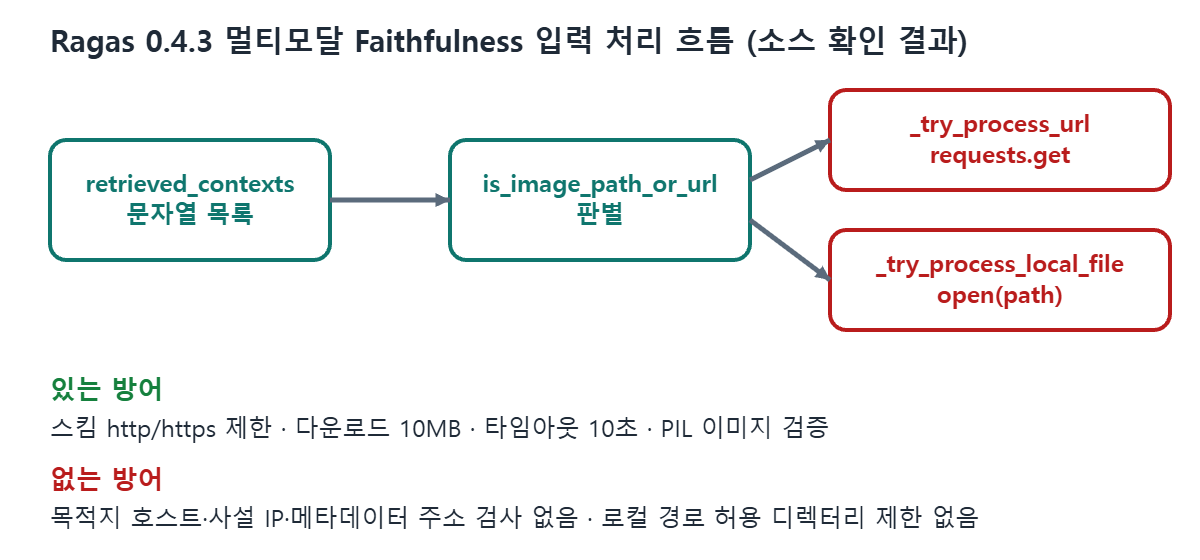
CVE-2026-6587은 멀티모달 Faithfulness 모듈의 서버 측 요청 위조(SSRF) 취약점입니다. 2026년 4월 20일 공개됐고, 영향 범위는 ragas 0.2.3 이상 0.4.3 이하입니다. 수정 버전은 아직 없습니다. 평가 입력인 retrieved_contexts에 URL이 들어오면 평가 서버가 그 주소로 직접 요청을 보내는 구조가 원인입니다.
심각도는 기관마다 다르게 매겼습니다. CVSS 3.1 기준 6.3, CVSS 4.0 기준 2.1이 많이 인용되고, Red Hat은 Important(8.1)로 봤습니다. 차이가 큰 이유는 “공격자가 평가 입력을 조작할 수 있는가”를 어떻게 가정하느냐에 달려 있기 때문입니다.
0.4.3 소스를 직접 열어 확인한 것
보도만 보고 판단하기보다 배포 파일을 직접 받아 봤습니다. pip download ragas==0.4.3 --no-deps로 휠을 받고, ragas/metrics/collections/multi_modal_faithfulness/util.py(285줄)를 읽었습니다.
- 있는 방어: URL 스킴을 http·https로 제한하고, 다운로드는 10MB, 타임아웃은 10초로 묶습니다. 받은 데이터는 PIL로 이미지인지 검증합니다.
- 없는 방어:
_try_process_url은 목적지 호스트를 검사하지 않고requests.get을 호출합니다. 사설 IP 대역이나 클라우드 메타데이터 주소를 막는 코드가 없습니다. - 로컬 파일:
_try_process_local_file은 문자열이 실제 파일 경로이면 크기만 확인하고 엽니다. 허용 디렉터리 제한은 없습니다. - 덤으로 본 것:
ragas/_analytics.py에 사용 통계 전송 주소가 기본으로 들어 있습니다. 환경변수RAGAS_DO_NOT_TRACK=true일 때만 꺼집니다.
정리하면, 텍스트 전용 지표만 쓰고 평가 데이터를 내부에서 만든다면 위험은 낮습니다. 반대로 사용자 업로드 문서나 웹 크롤링 결과가 그대로 retrieved_contexts로 들어가는 구조라면, 평가 서버가 내부망을 두드리는 통로가 될 수 있습니다.
폐쇄망 RAG 평가를 설계하며 정한 기준
최근 국내 대형 제조사의 사내 LLM 플랫폼을 설계하면서 평가 단계를 따로 떼어 정리했습니다. 150~200명이 쓰는 폐쇄망 환경이고, vLLM 추론 서버와 Milvus 하이브리드 검색을 묶은 구성입니다. 이 환경에서 Ragas 평가를 넣을 때 세운 기준은 다음과 같습니다.
- 심판 LLM도 내부 모델로 둡니다. 평가 데이터에는 실제 사내 문서 조각이 들어가므로, 외부 API 심판은 처음부터 선택지에서 뺐습니다.
- 평가 서버의 외부 통신을 막습니다. 위에서 본 사용 통계 전송처럼, 라이브러리가 몰래 나가는 요청이 있는지 이그레스 단에서 차단하는 편이 확실합니다.
- 지표 정의를 라이브러리 밖에 적어 둡니다. Faithfulness를 “주장 단위 지지 비율”로 문서화해 두면, 도구를 바꿔도 점수의 의미가 이어집니다.
- 임베딩 비교와 평가를 같은 골든셋으로 돌립니다. Qwen3-Embedding-8B와 BGE-M3 비교처럼 검색 구성을 바꿀 때, 같은 질문 세트로 Context Recall을 다시 재야 비교가 됩니다.
이번 CVE를 보고 하나를 더 추가했습니다. 문서에 이미지가 섞인 도면·사양서를 다루더라도, 멀티모달 지표는 격리된 평가 환경에서만 돌린다는 원칙입니다.
지금 Ragas 평가를 쓰는 팀의 점검 순서
당장 다른 도구로 옮기지 않아도 됩니다. 아래 순서대로 위험을 줄이고, 그다음에 이전 여부를 판단하면 됩니다.
- 설치 버전을 확인하고 고정합니다.
pip show ragas로 0.2.3~0.4.3 범위인지 봅니다. - 멀티모달 Faithfulness를 쓰는지 코드에서 찾습니다. 쓰지 않는다면 이 CVE의 직접 영향은 작습니다.
- 쓴다면
retrieved_contexts가 어디서 오는지 추적합니다. 외부 입력이 섞이면 아래처럼 사전 필터를 둡니다. - 평가 실행 환경에
RAGAS_DO_NOT_TRACK=true를 넣고, 사설망·메타데이터 주소로 나가는 요청을 막습니다. - 지표 정의서와 골든셋을 정리한 뒤 DeepEval·Giskard 같은 대안으로 같은 세트를 돌려 점수 차이를 봅니다.
사전 필터는 평가 호출 직전에 문맥 목록을 걸러내는 방식이 가장 간단합니다.
import ipaddress, socket
from urllib.parse import urlparse

def is_safe_context(item: str) -> bool:
    p = urlparse(item)
    if p.scheme in ("http", "https"):
        try:
            ip = ipaddress.ip_address(socket.gethostbyname(p.hostname))
        except Exception:
            return False
        return not (ip.is_private or ip.is_loopback or ip.is_link_local)
    # 로컬 경로처럼 보이는 문자열은 평가 입력에서 제외
    return not item.startswith(("/", "./", "../", "file:"))

sample["retrieved_contexts"] = [c for c in sample["retrieved_contexts"] if is_safe_context(c)]
DNS 재바인딩까지 막지는 못하므로, 네트워크 차단과 함께 쓰는 보조 장치로 봐야 합니다. 프롬프트 인젝션처럼 모델 밖에서 막아야 하는 문제라는 점은 애플리케이션 코드가 지켜야 하는 방어와 같은 결입니다.
자주 묻는 질문(FAQ)
Ragas는 이제 쓰면 안 되나요?
그렇지 않습니다. 텍스트 지표를 내부 데이터로만 돌린다면 지금도 쓸 만합니다. 다만 업데이트가 멈춘 상태이므로 버전을 고정하고, 지표 정의를 따로 문서화해 두는 것이 좋습니다.
CVE-2026-6587은 패치됐나요?
2026년 11월 기준으로 수정 버전은 공개되지 않았습니다. 영향 범위는 0.2.3부터 0.4.3까지이며, 멀티모달 Faithfulness 모듈을 쓸 때 문제가 됩니다. 입력 필터와 네트워크 차단으로 완화해야 합니다.
Ragas 평가 점수만으로 운영 배포를 결정해도 되나요?
권하지 않습니다. 심판 LLM의 판단에도 편향과 흔들림이 있습니다. 소규모라도 사람이 검수한 골든셋과 함께 보고, 점수 변화의 이유를 행동 단위로 확인하는 편이 안전합니다. 이 관점은 에이전트 행동 평가 글에서도 다뤘습니다.
대안 도구로 바로 옮겨야 하나요?
먼저 골든셋과 지표 정의를 정리한 뒤 같은 데이터로 비교하는 것이 순서입니다. Giskard 3.0은 기존 API와 호환되지 않는 재작성이라 이전 비용을 따져 봐야 합니다.
마무리
Ragas 평가가 만든 Faithfulness·Context Recall 같은 용어는 여전히 RAG 품질을 말하는 공통 언어입니다. 바뀐 것은 라이브러리를 둘러싼 운영 조건입니다. 버전 고정, 텔레메트리 차단, 멀티모달 입력 필터, 지표 정의 문서화 네 가지만 해 두면 지금 쓰는 파이프라인을 안전하게 유지하면서 다음 도구를 고를 시간을 벌 수 있습니다.
참고 자료
- Es et al., Ragas: Automated Evaluation of Retrieval Augmented Generation (arXiv)
- NVD, CVE-2026-6587
- GitLab Advisory Database, RAGAS SSRF via Multi-Modal Faithfulness
- vibrantlabsai/ragas 릴리스 이력
- RAG evaluation tools 2026: Ragas vs DeepEval vs Braintrust vs Giskard
보안 취약점 정보는 2026년 11월 16일 기준 공개 자료를 바탕으로 했으며, 적용 전 각 기관의 최신 권고를 확인하시기 바랍니다.