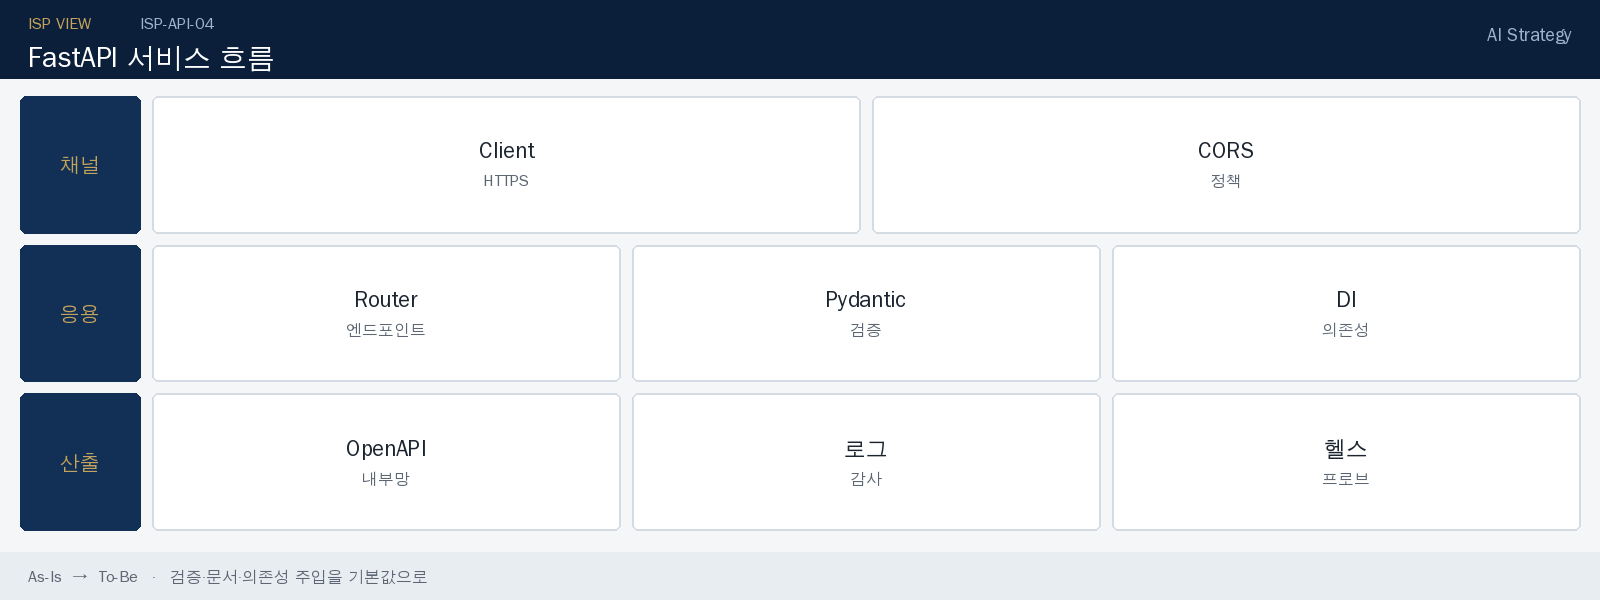
왜 “따라하면 되는” FastAPI 튜토리얼이 사고로 이어지는가
FastAPI 공식 튜토리얼과 대부분의 입문 가이드는 학습 목적상 최소한의 코드만 보여줍니다. 문제는 이 코드를 그대로 복사해 사내 프로젝트나 PoC 서버에 올리는 경우가 실무에서 생각보다 많다는 것입니다. 튜토리얼 코드에는 SQL 인젝션에 취약한 문자열 결합, 하드코딩된 시크릿 키, 평문 비밀번호 비교 같은 패턴이 “설명을 단순하게 하기 위해” 아무 경고 없이 등장합니다. 이 글은 FastAPI 사용법을 처음부터 나열하는 대신, 컨설팅 현장에서 실제로 발견했던 “튜토리얼에서 프로덕션으로 넘어갈 때 깨지는 지점”을 정리합니다.
튜토리얼과 프로덕션 사이에서 실제로 사고가 나는 세 지점
사내 PoC 서버를 검수하면서 반복적으로 마주친 패턴은 정해져 있습니다. 첫째, 필터링·검색 엔드포인트를 f-string으로 SQL을 조립하는 경우입니다. f” AND name LIKE ‘%{name}%'” 같은 코드는 튜토리얼에서는 “이해하기 쉽다”는 이유로 자주 등장하지만, 사용자 입력이 그대로 쿼리에 들어가는 순간 SQL 인젝션 통로가 됩니다. 둘째, JWT 서명에 쓰는 SECRET_KEY를 코드에 문자열로 박아 넣고 그대로 배포하는 경우입니다. 깃허브에 공개 저장소로 올라가는 순간 토큰 위조가 가능해집니다. 셋째, 로그인 로직을 if username == “admin” and password == “password” 식으로 평문 비교하는 튜토리얼 패턴을 그대로 옮기는 경우입니다. 이 세 가지는 전부 “튜토리얼이니까 괜찮다”고 넘어가기 쉽지만, 실제로 PoC가 사내망 안에서라도 실사용자 데이터를 다루기 시작하면 그 순간부터 취약점입니다.
| 영역 | 튜토리얼에서 흔한 패턴 | 프로덕션에서 반드시 바꿔야 할 것 |
|---|---|---|
| 쿼리 조합 | f-string으로 직접 SQL 조립 | ORM 파라미터 바인딩 또는 prepared statement |
| 시크릿 관리 | 코드에 문자열로 하드코딩 | 환경 변수 + 시크릿 매니저, 저장소에 커밋 금지 |
| 비밀번호 검증 | 평문 문자열 비교 | bcrypt/argon2 해시 비교, 원문 저장 금지 |
| 에러 응답 | 스택 트레이스를 그대로 노출 | 사용자에게는 일반화된 메시지, 상세는 서버 로그에만 |
| Rate limiting | 보통 생략 | 인증·검색 엔드포인트는 최소한의 제한 필수 |
Pydantic 검증과 의존성 주입이 실제로 막아주는 것
FastAPI를 Flask 대신 고르는 실질적인 이유는 속도 벤치마크가 아니라, 요청 검증과 API 문서화가 프레임워크 기본값으로 강제된다는 점입니다. Pydantic 모델 없이 dict를 그대로 받으면 사실상 Flask를 쓰는 것과 같은 셈이라, 입력 검증을 개발자가 매번 손으로 챙겨야 합니다.
from fastapi import FastAPI, Depends, HTTPException
from sqlalchemy.orm import Session
from sqlalchemy import text

app = FastAPI()

# 안전한 파라미터 바인딩 - f-string 조립 대신
@app.get("/users")
def search_users(name: str | None = None, db: Session = Depends(get_db)):
    query = db.query(User)
    if name:
        # ORM 필터는 내부적으로 파라미터 바인딩을 사용합니다
        query = query.filter(User.name.like(f"%{name}%"))
    return query.limit(50).all()

# 환경 변수에서만 시크릿을 읽고, 없으면 기동 자체를 막습니다
import os
SECRET_KEY = os.environ["JWT_SECRET_KEY"]  # 없으면 KeyError로 즉시 실패

# 비밀번호는 해시로만 비교합니다
from passlib.context import CryptContext
pwd_context = CryptContext(schemes=["bcrypt"], deprecated="auto")

def verify_login(plain_password: str, hashed_password: str) -> bool:
    return pwd_context.verify(plain_password, hashed_password)
SQLAlchemy의 filter(User.name.like(…)) 방식은 내부적으로 파라미터 바인딩을 사용하므로 f-string으로 직접 SQL 문자열을 조립하는 것과 근본적으로 다릅니다. 시크릿을 os.environ[“JWT_SECRET_KEY”]로 읽게 하면, 배포 환경에 값이 없을 때 조용히 기본값으로 넘어가는 대신 즉시 기동에 실패해 사고를 예방합니다.
구현에서 실제로 자주 빠뜨리는 지점
Pydantic 검증과 안전한 쿼리를 갖췄다고 끝이 아닙니다. 첫째, 자동 생성되는 /docs Swagger UI를 인증 없이 외부에 그대로 열어 두는 경우가 많습니다. 내부 API 구조와 스키마가 그대로 노출되므로 내부망 또는 인증 뒤로 두어야 합니다. 둘째, 에러 핸들러를 커스텀하지 않으면 디버그 모드에서 스택 트레이스가 응답에 그대로 노출되어 서버 내부 구조를 외부에 알려주는 꼴이 됩니다. 셋째, 비동기 엔드포인트(async def) 안에서 동기 블로킹 DB 드라이버를 그대로 호출하면 이벤트 루프 전체가 멈춰, 오히려 동기 방식보다 처리량이 떨어지는 역설적인 상황이 발생합니다. 비동기 이점을 실제로 누리려면 비동기 드라이버(asyncpg 등)로 맞춰야 합니다.
Rate limiting과 백그라운드 작업 — 흔히 생략하지만 필요한 두 가지
튜토리얼에는 거의 등장하지 않지만, 프로덕션에서 인증·검색 엔드포인트에는 최소한의 요청 제한이 필요합니다. slowapi 같은 미들웨어로 IP 또는 사용자 단위 제한을 걸거나, 게이트웨이(Nginx, API Gateway) 레벨에서 처리하는 것이 일반적입니다.
from slowapi import Limiter
from slowapi.util import get_remote_address

limiter = Limiter(key_func=get_remote_address)
app.state.limiter = limiter

@app.post("/login")
@limiter.limit("5/minute")  # 브루트포스 방어의 최소 조건
def login(request: Request, credentials: LoginRequest):
    ...
이메일 발송, 파일 처리처럼 응답을 기다리게 하면 안 되는 작업은 FastAPI의 BackgroundTasks로 처리할 수 있지만, 이는 같은 프로세스 안에서 동작하므로 서버가 재시작되면 작업이 유실됩니다. 재시도가 필요하거나 여러 워커에 걸쳐 안정적으로 실행되어야 하는 작업(결제 후처리, 대량 리포트 생성 등)은 처음부터 Celery나 RQ 같은 별도 작업 큐로 분리하는 것이 안전합니다. “일단 BackgroundTasks로 시작했다가 나중에 옮기면 된다”는 판단은 재시도·모니터링 로직을 다시 짜야 하는 비용을 뒤로 미루는 것일 뿐입니다.
한계와 제언
FastAPI가 항상 정답은 아닙니다. 관리자 페이지, 폼 기반 CRUD처럼 Django의 admin·ORM·인증 시스템이 통째로 필요한 경우라면 FastAPI로 그 모든 것을 직접 조립하는 비용이 오히려 더 큽니다. 반대로 아주 단순한 내부 스크립트 API라면 Flask 한 파일로 충분한 경우도 많습니다. FastAPI를 고르는 기준은 “빠르다”가 아니라, 요청 검증과 OpenAPI 문서화가 팀 표준으로 강제되어야 하는 상황인가입니다. 어떤 프레임워크를 쓰든, 프로덕션 배포 전에는 이 글에서 다룬 세 가지(쿼리 파라미터 바인딩, 시크릿 환경 변수화, 해시 기반 인증)만큼은 예외 없이 확인하는 것을 권장합니다.
프로덕션에서 튜토리얼이 빼먹는 운영 값
검증과 해시를 고친 뒤에도 사고는 타임아웃과 워커에서 납니다. uvicorn 기본 워커 하나로 동기 ORM을 물리면, 느린 쿼리 하나가 전체 API를 세웁니다. 워커 수는 CPU가 아니라 DB 풀 크기와 맞춰야 합니다. 워커 8에 풀 5면 세 워커는 연결을 기다리다 타임아웃합니다.
| 설정 | 튜토리얼 | 사내 API에서 쓰는 값 |
|---|---|---|
| CORS | allow_origins=[“*”] | 프론트 오리진만, 자격 증명과 짝 |
| /docs | 공개 | 내부망 또는 인증 뒤 |
| 타임아웃 | 없음 | 게이트웨이 29초보다 짧게 |
| 헬스 | / 200 | liveness와 readiness 분리 |
배포 시 워커 수를 계산하는 방법
gunicorn으로 uvicorn 워커를 여러 개 띄울 때, 흔히 “CPU 코어 수 × 2 + 1” 공식을 그대로 적용하지만 이는 CPU-바운드 워크로드 기준입니다. DB I/O가 많은 API는 워커 수를 DB 커넥션 풀 크기 이하로 맞추는 것이 먼저입니다. 워커 하나당 필요한 연결 수를 곱했을 때 DB의 max_connections를 넘지 않는지 배포 전에 반드시 계산해야 합니다.
테스트가 프로덕션 의존성을 그대로 부르면 안 된다
Depends로 붙인 DB·시크릿을 테스트에서 그대로 쓰면 CI가 스테이징을 칩니다. dependency_overrides로 세션과 시계를 바꿉니다. 시계를 고정하지 않은 JWT 테스트는 만료 경계에서만 실패해, 평소엔 초록입니다.
에러 본문에 SQLAlchemy 메시지를 그대로 넣으면 테이블 이름이 나갑니다. 사용자 응답은 코드와 짧은 문구, 상세는 구조화 로그의 request_id에만 남깁니다. 비동기 라우트에서 time.sleep이나 동기 requests를 쓰면 이벤트 루프가 멈춥니다. 외부 호출은 httpx.AsyncClient와 기한, 재시도 횟수를 명시합니다. 재시도는 멱등 GET만 허용합니다. POST를 재시도하면 주문이 두 번 생깁니다.
관측 가능성 — 로그만으로는 부족한 이유
request_id를 로그에 남기는 것만으로는 여러 서비스에 걸친 요청을 추적하기 어렵습니다. FastAPI 미들웨어에서 요청마다 상관관계 ID(correlation ID)를 생성하고, 이 ID를 하위 서비스 호출의 헤더에 전파한 뒤, OpenTelemetry 같은 표준 트레이싱 라이브러리로 수집하면 장애 시 “어느 서비스에서 지연이 시작됐는가”를 로그 여러 개를 손으로 대조하지 않고도 확인할 수 있습니다. 사내 API가 두세 개를 넘어가는 시점부터는 구조화 로깅과 트레이싱을 뒤늦게 붙이는 비용이 처음부터 넣는 비용보다 훨씬 큽니다.
Takeaway
- FastAPI 튜토리얼 코드에는 학습 편의를 위한 보안 취약 패턴(f-string SQL, 하드코딩 시크릿, 평문 비밀번호 비교)이 그대로 남아 있는 경우가 많습니다.
- SQLAlchemy 필터·ORM 파라미터 바인딩을 쓰면 f-string으로 SQL을 직접 조립하는 것과 근본적으로 다른 안전성을 얻습니다.
- 시크릿은 코드가 아니라 환경 변수로 읽고, 값이 없으면 조용히 넘어가지 않고 기동 자체가 실패하게 만드십시오.
- 비동기 엔드포인트에서 동기 블로킹 드라이버를 쓰면 이벤트 루프가 막혀 동기 방식보다 처리량이 떨어질 수 있습니다.
- 워커 수는 CPU가 아니라 DB 커넥션 풀 크기 기준으로 계산해야 하며, 재시도가 필요한 장시간 작업은 BackgroundTasks가 아니라 별도 작업 큐로 분리합니다.
- API가 두세 개를 넘어가면 상관관계 ID 기반 구조화 로깅과 트레이싱을 처음부터 넣는 것이 나중에 붙이는 것보다 훨씬 저렴합니다.