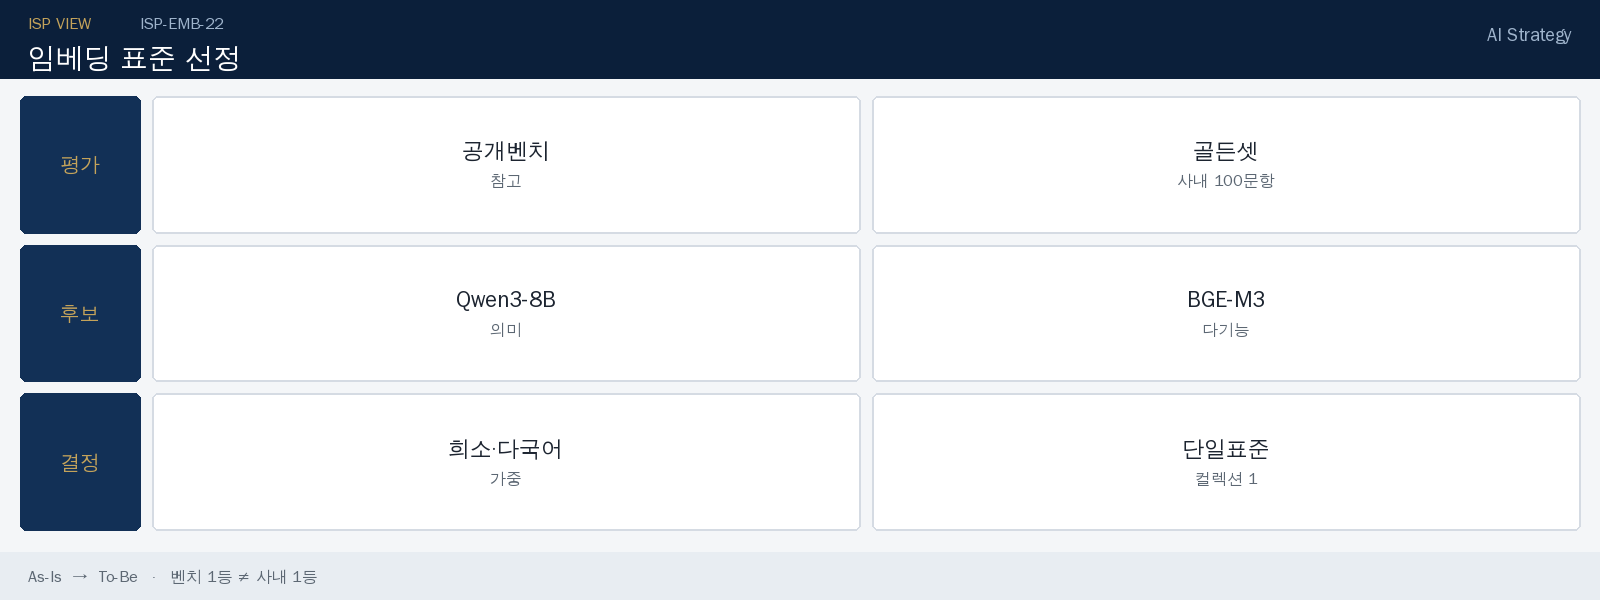
두 최상위 임베딩 모델의 아키텍처, 성능, 설치, 구현 방식을 심층 비교하여 프로젝트에 맞는 최적의 선택 기준을 제시합니다.
작성일: 2026년 8월 4일
목차
- 서론: 왜 두 모델을 비교해야 하는가
- 아키텍처 비교: 설계 철학의 차이
- 정량적 성능 비교: 벤치마크 분석
- Milvus 하이브리드 검색 통합 구조 비교
- 설치 및 환경 구성 비교 가이드
- 구현 코드 비교: 동일 시나리오 실습
- 결과 융합 알고리즘 적용 비교
- 운영 관점의 비교: 비용, 지연시간, 확장성
- 시나리오별 선택 가이드
- 결론 및 종합 권고사항
1. 서론: 왜 두 모델을 비교해야 하는가
벡터 데이터베이스 기반의 하이브리드 검색 시스템을 설계할 때 실무자가 가장 먼저 마주하는 의사결정은 어떤 임베딩 모델을 채택할 것인가라는 문제입니다. 2025년 이후 공개된 다양한 임베딩 모델 가운데, Alibaba의 Qwen3-Embedding-8B와 BAAI의 BGE-M3는 각각 서로 다른 설계 철학을 바탕으로 하이브리드 검색 분야에서 가장 널리 채택되는 두 축을 형성하고 있습니다.
Qwen3-Embedding-8B는 80억 매개변수의 대규모 언어 모델을 백본으로 삼아 순수 밀집 검색 성능의 극대화를 지향하는 모델이며, MTEB 다국어 리더보드에서 최상위권을 기록하고 있습니다. 반면 BGE-M3는 상대적으로 가벼운 단일 모델 안에 밀집 검색, 희소 검색, 다중 벡터 검색이라는 세 가지 기능을 통합함으로써 시스템 아키텍처의 단순화를 지향하는 모델입니다.
두 모델은 “하이브리드 검색”이라는 동일한 목표를 서로 다른 경로로 달성한다는 점에서 흥미로운 비교 대상이 됩니다. 이 기록에서는 두 모델의 아키텍처적 차이부터 실제 Milvus 통합 코드, 정량적 벤치마크, 운영 비용에 이르기까지 박사 연구자의 관점에서 균형 있게 비교 분석하고, 실무 시나리오별 선택 기준을 제시하도록 하겠습니다.
2. 아키텍처 비교: 설계 철학의 차이
2.1 핵심 사양 비교표
| 항목 | Qwen3-Embedding-8B | BGE-M3 |
|---|---|---|
| 개발 기관 | Alibaba (Qwen팀) | BAAI (베이징 AI 연구원) |
| 매개변수 규모 | 80억 (8B) | 약 5.6억 (0.56B) |
| 기본 지원 검색 방식 | 밀집 검색 (단일 기능 특화) | 밀집·희소·다중벡터 (3기능 통합) |
| 최대 컨텍스트 길이 | 32,000 토큰 | 8,192 토큰 |
| 밀집 벡터 차원 | 최대 4096 (가변 축소 지원) | 1024 (고정) |
| MTEB 다국어 점수 | 70.58 (2025년 6월 1위) | 공식 MTEB 1위 미기록, 검색 특화 지표 우수 |
| 지원 언어 | 100개 이상 | 100개 이상 (194개 언어 학습) |
| 희소 벡터 자체 생성 | 미지원 (Milvus BM25 함수 별도 필요) | 지원 (모델 자체 출력) |
| PyMilvus 통합 클래스 | SentenceTransformerEmbeddingFunction | BGEM3EmbeddingFunction (전용 클래스) |
2.2 학습 방법론의 근본적 차이
Qwen3-Embedding-8B는 Qwen3 대규모 언어 모델을 백본으로 삼아 대조 학습(Contrastive Learning) 기법으로 파인튜닝된 모델로, 순수하게 밀집 벡터 표현의 품질을 극대화하는 데 초점을 둡니다. 희소 검색이 필요한 경우에는 Milvus가 제공하는 별도의 BM25 내장 함수를 조합하여 하이브리드 구조를 구성해야 합니다.
반면 BGE-M3는 자기 지식 증류(Self-Knowledge Distillation)라는 독자적인 학습 프레임워크를 통해 밀집, 희소, 다중 벡터라는 세 가지 검색 기능이 단일 모델의 학습 과정에서 상호 보완적으로 강화되도록 설계되었습니다. 이는 곧 희소 벡터 생성을 위한 별도의 서버 측 함수나 외부 라이브러리 없이, 모델 자체가 두 가지 벡터를 동시에 출력한다는 실질적인 차이로 이어집니다.
3. 정량적 성능 비교: 벤치마크 분석
3.1 종합 벤치마크 관점
MTEB 다국어 리더보드 기준으로는 Qwen3-Embedding-8B가 70.58점으로 2025년 6월 기준 1위를 기록하며, GTE 및 BGE 계열 모델을 전반적으로 상회하는 것으로 나타납니다. 이는 대규모 매개변수와 광범위한 사전학습 데이터의 이점이 반영된 결과로 해석됩니다.
3.2 특정 검색 시나리오에서의 역전 현상
그러나 종합 벤치마크 순위가 모든 상황에서 절대적인 우위를 의미하지는 않습니다. 일부 실무 검증 연구에서는 특정 검색 시나리오, 특히 하이브리드 검색이 강점을 발휘하는 조건에서 BGE-M3가 더 높은 히트율(Hit Rate)을 기록한 사례가 보고되었습니다. 예를 들어 상위 3개 결과 기준(k=3) 히트율 비교에서 BGE-M3가 Qwen3-Embedding 대비 약 63퍼센트 높은 수치를 기록한 연구 결과가 존재합니다. 이는 BGE-M3의 희소 검색 기능이 결합된 하이브리드 방식이 특정 도메인의 정확한 용어 매칭 요구사항에 더 효과적으로 대응했기 때문으로 분석됩니다.
이러한 상반된 결과는 임베딩 모델 선택에 있어 단일 벤치마크 점수만으로 판단하는 것의 위험성을 시사합니다. 실제 서비스 도메인의 쿼리 특성, 문서 유형, 언어 분포를 반영한 자체 평가가 병행되어야 함을 의미합니다.
3.3 차원 축소와 정확도의 관계
Qwen3-Embedding-8B는 4096차원 임베딩을 생성할 경우 상위 3개 정확도(Top-3 Accuracy) 0.571, NDCG@3 0.516 수준의 성능을 보이는 것으로 보고되었습니다. Qwen3 계열은 0.6B에서 8B까지 다양한 매개변수 규모와 1024, 2560, 4096차원의 유연한 벡터 크기를 지원하여, 정확도와 저장 비용 사이의 균형을 세밀하게 조정할 수 있다는 장점이 있습니다. BGE-M3는 1024차원으로 고정되어 있어 이러한 유연성은 제한적이나, 대신 항상 일관된 저장 공간과 연산 비용을 예측할 수 있다는 운영상의 이점이 있습니다.
4. Milvus 하이브리드 검색 통합 구조 비교
4.1 Qwen3-Embedding-8B 기반 구조
Qwen3-Embedding-8B를 사용하는 경우, 하이브리드 검색을 구현하려면 두 개의 독립적인 구성 요소가 필요합니다. 첫째, 모델이 생성하는 밀집 벡터를 저장할 FLOAT_VECTOR 필드입니다. 둘째, Milvus 서버가 내장 BM25 함수(FunctionType.BM25)를 통해 텍스트 필드로부터 자동 생성하는 SPARSE_FLOAT_VECTOR 필드입니다. 즉, 밀집 벡터는 모델이, 희소 벡터는 Milvus 서버가 각각 담당하는 이원화된 구조입니다.
4.2 BGE-M3 기반 구조
BGE-M3를 사용하는 경우, 밀집 벡터와 희소 벡터가 모두 모델의 단일 함수 호출(bge_m3_ef(documents))에서 동시에 반환됩니다. Milvus는 두 벡터를 저장하고 인덱싱하는 역할만 담당하며, 별도의 서버 측 BM25 계산 함수를 구성할 필요가 없습니다. 이는 파이프라인의 구성 요소 수를 줄여 시스템 복잡도를 낮추는 효과가 있습니다.
4.3 구조적 차이의 실무적 함의
Qwen3-Embedding-8B 방식은 Milvus의 네이티브 전문 검색 기능을 그대로 활용하므로, 형태소 분석기(Analyzer) 설정을 세밀하게 커스터마이징할 수 있다는 유연성이 있습니다. 반면 BGE-M3 방식은 모델이 학습한 희소 표현을 그대로 사용하므로 별도의 분석기 튜닝 없이도 즉시 사용 가능하지만, Milvus의 BM25 파라미터(k1, b 등)를 세밀하게 조정하는 유연성은 상대적으로 제한적입니다.
5. 설치 및 환경 구성 비교 가이드
5.1 공통 사전 요구사항
두 모델 모두 Python 3.9 이상, 최소 8GB 메모리 환경을 필요로 합니다. Qwen3-Embedding-8B는 80억 매개변수 규모로 인해 GPU 메모리 최소 16GB를 권장하는 반면, BGE-M3는 약 5.6억 매개변수의 경량 모델로 CPU 환경에서도 실용적인 처리 속도를 낼 수 있습니다.
5.2 공통 기반 패키지 설치
# PyMilvus 및 모델 통합 확장 패키지 설치 (두 모델 공통) pip install –upgrade pymilvus pip install “pymilvus[model]” # 특정 버전 고정 설치 (재현성 확보 목적) pip install pymilvus==2.5.4
명령어 상세 설명입니다:
pymilvus[model]은 extras 문법을 통해 두 모델 모두에 필요한 sentence-transformers, FlagEmbedding, torch 등의 부가 라이브러리를 한 번에 설치합니다.- 버전을
==으로 고정하는 것은 두 모델을 병행 비교하는 실험 환경에서 API 변경으로 인한 결과 재현 불가 문제를 방지하기 위한 모범 사례입니다.
5.3 모델별 추가 설치 (분기)
# — Qwen3-Embedding-8B 전용 — pip install sentence-transformers torch transformers # — BGE-M3 전용 — pip install FlagEmbedding
Qwen3-Embedding-8B는 Hugging Face의 sentence-transformers 생태계를 통해 로드되며, BGE-M3는 BAAI가 직접 배포하는 FlagEmbedding 라이브러리를 기반으로 PyMilvus 전용 래퍼가 구현되어 있습니다.
5.4 Docker 기반 Milvus 서버 설치 (공통)
# 공식 설치 스크립트 다운로드 curl -sfL https://raw.githubusercontent.com/milvus-io/milvus/master/scripts/standalone_embed.sh -o standalone_embed.sh # 컨테이너 시작 bash standalone_embed.sh start # 실행 상태 확인 docker ps | grep milvus
명령어 상세 설명입니다:
-sfL플래그는 각각 진행률 숨김, 오류 시 실패 처리, 리다이렉트 자동 추적을 의미하며, 두 모델 구성 모두에서 동일하게 사용되는 Milvus 서버 자체의 설치 절차입니다.- 두 모델은 동일한 Milvus 서버 인스턴스를 공유할 수 있으며, 컬렉션 단위로 분리하여 병행 운영하거나 A/B 테스트를 수행하는 것이 일반적입니다.
5.5 모델 초기화 비교
# — Qwen3-Embedding-8B 초기화 — from pymilvus.model.dense import SentenceTransformerEmbeddingFunction qwen_ef = SentenceTransformerEmbeddingFunction( model_name=”Qwen/Qwen3-Embedding-8B”, device=”cuda”, trust_remote_code=True ) # — BGE-M3 초기화 — from pymilvus.model.hybrid import BGEM3EmbeddingFunction bge_ef = BGEM3EmbeddingFunction( model_name=”BAAI/bge-m3″, device=”cpu”, use_fp16=False )
두 초기화 코드의 근본적 차이는 임포트 경로에서부터 드러납니다. Qwen3-Embedding-8B는 pymilvus.model.dense 모듈의 범용 클래스를 사용하는 반면, BGE-M3는 pymilvus.model.hybrid 모듈의 전용 클래스를 사용합니다. 이는 PyMilvus 개발팀이 BGE-M3의 다기능성을 얼마나 중요하게 취급했는지를 보여주는 설계상의 근거이기도 합니다.
6. 구현 코드 비교: 동일 시나리오 실습
6.1 동일 문서 집합에 대한 임베딩 생성 비교
documents = [ “리튬이온 배터리의 열관리 시스템은 전기차 안전성의 핵심 요소입니다.”, “하이브리드 검색은 키워드 매칭과 의미론적 검색을 결합한 방식입니다.”, ] # — Qwen3-Embedding-8B: 밀집 벡터만 반환 — qwen_dense = qwen_ef.encode_documents(documents) print(f”Qwen 밀집 벡터 차원: {len(qwen_dense[0])}”) # 결과: 4096 (기본 설정 시) # — BGE-M3: 밀집 + 희소 벡터 동시 반환 — bge_result = bge_ef(documents) print(f”BGE 밀집 벡터 차원: {len(bge_result[‘dense’][0])}”) # 결과: 1024 print(f”BGE 희소 벡터 타입: {type(bge_result[‘sparse’])}”) # CSR 행렬
가장 뚜렷한 차이는 반환값의 구조입니다. Qwen3-Embedding-8B의 encode_documents()는 밀집 벡터 리스트만 반환하는 단일 출력 함수인 반면, BGE-M3는 dense와 sparse 키를 가진 딕셔너리를 반환하는 다중 출력 함수입니다. 이 차이로 인해 Qwen 기반 파이프라인에서는 희소 벡터 생성을 위한 별도의 Milvus 스키마 함수(BM25 Function) 정의가 필수적으로 요구됩니다.
6.2 컬렉션 스키마 비교
from pymilvus import DataType, Function, FunctionType # — Qwen3-Embedding-8B용 스키마: BM25 함수 명시적 정의 필요 — qwen_schema = client.create_schema(auto_id=True, enable_dynamic_field=True) qwen_schema.add_field(“id”, DataType.INT64, is_primary=True) qwen_schema.add_field(“text”, DataType.VARCHAR, max_length=65535, enable_analyzer=True) qwen_schema.add_field(“dense_vector”, DataType.FLOAT_VECTOR, dim=4096) qwen_schema.add_field(“sparse_vector”, DataType.SPARSE_FLOAT_VECTOR) qwen_schema.add_function(Function( name=”text_bm25″, input_field_names=[“text”], output_field_names=[“sparse_vector”], function_type=FunctionType.BM25 )) # — BGE-M3용 스키마: 함수 정의 불필요, 벡터 필드만 정의 — bge_schema = client.create_schema(auto_id=True, enable_dynamic_field=True) bge_schema.add_field(“id”, DataType.INT64, is_primary=True) bge_schema.add_field(“text”, DataType.VARCHAR, max_length=65535) bge_schema.add_field(“dense_vector”, DataType.FLOAT_VECTOR, dim=1024) bge_schema.add_field(“sparse_vector”, DataType.SPARSE_FLOAT_VECTOR)
BGE-M3 스키마는 add_function() 호출이 필요 없다는 점에서 코드가 더 간결합니다. 이는 희소 벡터가 삽입 시점에 이미 모델에 의해 계산된 값으로 제공되기 때문이며, Milvus는 단순히 이를 저장하는 역할만 수행합니다.
7. 결과 융합 알고리즘 적용 비교
7.1 RRF 적용 방식의 공통점
두 모델 모두 Milvus의 hybrid_search() API와 RRFRanker를 동일하게 활용할 수 있다는 점은 중요한 공통점입니다. 결과 융합 단계는 임베딩 모델의 종류와 무관하게 동일한 인터페이스로 처리되므로, 모델 교체 시에도 융합 로직 자체는 재사용이 가능합니다.
from pymilvus import AnnSearchRequest, RRFRanker query = “전기차 배터리 안전 관리 방법” ranker = RRFRanker(k=60) # 두 모델 모두 동일한 hybrid_search 인터페이스 사용 results = client.hybrid_search( collection_name=collection_name, reqs=[dense_request, sparse_request], # 모델에 따라 생성 방식만 다름 ranker=ranker, limit=5, output_fields=[“text”] )
7.2 쿼리 임베딩 생성 단계의 차이
# — Qwen3-Embedding-8B: 밀집 벡터만 생성, 희소는 원문 텍스트 그대로 전달 — query_dense = qwen_ef.encode_queries([query])[0] dense_request = AnnSearchRequest( data=[query_dense], anns_field=”dense_vector”, param={“metric_type”: “COSINE”, “params”: {“ef”: 128}}, limit=10 ) sparse_request = AnnSearchRequest( data=[query], anns_field=”sparse_vector”, # 원문 텍스트 그대로 전달 param={“metric_type”: “BM25”}, limit=10 ) # — BGE-M3: 밀집 + 희소 벡터 모두 사전 계산하여 전달 — query_emb = bge_ef([query]) dense_request = AnnSearchRequest( data=[query_emb[“dense”][0]], anns_field=”dense_vector”, param={“metric_type”: “IP”, “params”: {“ef”: 100}}, limit=10 ) sparse_request = AnnSearchRequest( data=[query_emb[“sparse”][[0]]], anns_field=”sparse_vector”, # 계산된 희소벡터 전달 param={“metric_type”: “IP”}, limit=10 )
Qwen3-Embedding-8B 구조에서는 희소 검색 요청 시 원문 텍스트 문자열을 그대로 전달하면 Milvus 서버가 내부적으로 BM25 점수를 계산하는 반면, BGE-M3 구조에서는 클라이언트 측에서 이미 계산된 희소 벡터(CSR 행렬)를 전달합니다. 이는 곧 Qwen 방식이 서버 부하가 상대적으로 높고, BGE-M3 방식이 클라이언트 연산 부하가 상대적으로 높다는 트레이드오프로 이어집니다.
8. 운영 관점의 비교: 비용, 지연시간, 확장성
8.1 인프라 비용 비교
| 항목 | Qwen3-Embedding-8B | BGE-M3 |
|---|---|---|
| 최소 GPU 메모리 | 16GB 이상 권장 | CPU로도 실용적 처리 가능 |
| 벡터 저장 공간 | 4096차원 기준 상대적으로 큼 | 1024차원 고정, 상대적으로 작음 |
| 희소 벡터 계산 위치 | Milvus 서버 측 (서버 부하 증가) | 클라이언트 측 (모델 추론 시 동시 계산) |
| 구성 요소 복잡도 | 모델 + BM25 서버 함수 (이원화) | 단일 모델 (통합) |
8.2 지연시간(Latency) 관점
Qwen3-Embedding-8B는 대규모 매개변수로 인해 단일 쿼리당 추론 지연시간이 BGE-M3 대비 상대적으로 높게 나타나는 경향이 있으며, 이는 실시간성이 중요한 서비스에서 배치 처리나 캐싱 전략의 중요성을 높입니다. BGE-M3는 경량 모델 특성상 CPU 환경에서도 비교적 안정적인 응답 속도를 제공하여, GPU 인프라 확보가 어려운 조직에서도 도입 장벽이 낮습니다.
8.3 확장성과 벡터 차원 유연성
Qwen3-Embedding-8B는 1024, 2560, 4096차원 중 선택이 가능한 가변 차원 축소(Matryoshka Representation Learning 유사 방식)를 지원하여, 저장 비용과 정확도 사이에서 세밀한 트레이드오프 조정이 가능합니다. BGE-M3는 1024차원으로 고정되어 있어 이러한 유연성은 없으나, 대신 예측 가능한 일관된 리소스 계획을 세울 수 있다는 안정성의 이점이 있습니다.
9. 시나리오별 선택 가이드
9.1 Qwen3-Embedding-8B가 유리한 경우
다음과 같은 상황에서는 Qwen3-Embedding-8B의 채택을 우선적으로 고려할 수 있습니다. 첫째, 순수 시멘틱 검색의 정확도가 최우선 과제이며 종합 벤치마크 최상위 성능이 요구되는 경우입니다. 둘째, 32,000 토큰에 이르는 매우 긴 문서를 청킹 없이 통째로 임베딩해야 하는 경우입니다. 셋째, GPU 인프라가 충분히 확보되어 있고 벡터 차원을 유연하게 조정하여 정확도와 비용을 세밀하게 튜닝하고자 하는 경우입니다.
9.2 BGE-M3가 유리한 경우
다음과 같은 상황에서는 BGE-M3의 채택을 우선적으로 고려할 수 있습니다. 첫째, 하나의 모델로 밀집·희소·다중벡터 검색을 모두 처리하여 시스템 아키텍처를 단순화하고자 하는 경우입니다. 둘째, GPU 인프라가 제한적이거나 CPU 기반 환경에서도 안정적인 서비스가 필요한 경우입니다. 셋째, 정확한 용어 매칭이 중요한 도메인(법률 조항, 제품 코드, 의료 용어 등)에서 하이브리드 검색의 실질적 개선 효과를 우선시하는 경우입니다. 넷째, 194개 언어라는 폭넓은 다국어 학습 데이터를 기반으로 한 안정적인 교차 언어 검색이 필요한 경우입니다.
9.3 두 모델을 병행 운영하는 하이브리드 전략
실무에서는 반드시 하나의 모델만을 선택할 필요는 없습니다. 1차 검색에는 연산 비용이 낮은 BGE-M3를 활용하여 넓은 후보군을 신속하게 확보하고, 정밀도가 중요한 2차 재순위화 단계에서만 Qwen3-Embedding-8B의 고차원 밀집 벡터를 활용하는 계층적(Cascading) 아키텍처도 실용적인 대안이 될 수 있습니다. 이러한 접근은 두 모델의 강점을 상호 보완적으로 활용하는 전략입니다.
10. 결론 및 종합 권고사항
이 기록에서는 Qwen3-Embedding-8B와 BGE-M3라는 두 최상위 임베딩 모델을 Milvus 하이브리드 검색이라는 동일한 맥락에서 아키텍처, 성능, 설치, 구현, 운영 비용의 다섯 가지 측면에서 비교 분석하였습니다. 두 모델은 우열을 가리기보다는 서로 다른 설계 철학에서 비롯된 상호 보완적인 도구로 이해하는 것이 타당합니다.
Qwen3-Embedding-8B는 대규모 매개변수를 기반으로 한 압도적인 밀집 검색 성능과 유연한 차원 조정 능력을 무기로 하며, BGE-M3는 단일 모델 내 다기능 통합을 통한 아키텍처 단순화와 자원 효율성을 무기로 합니다. 최종적인 선택은 종합 벤치마크 점수만이 아니라, 실제 서비스의 쿼리 특성, 인프라 예산, 응답 시간 요구사항, 그리고 자체적으로 수행한 도메인 특화 평가 결과를 종합적으로 고려하여 이루어져야 합니다.
벡터 검색과 임베딩 모델 생태계는 매우 빠른 속도로 발전하고 있으므로, 본 비교 분석 역시 지속적으로 갱신되는 최신 벤치마크와 공식 문서를 기준으로 재검증하는 자세가 필요합니다.
참고 자료 및 출처
본 글은 다음의 공식 문서와 자료를 기반으로 작성되었습니다:
- Milvus Hybrid Search Retriever | Milvus Documentation
- BGE M3 | Milvus Documentation
- Hands-on RAG with Qwen3 Embedding and Reranking Models using Milvus | Milvus Blog
- bge-m3 vs Qwen3 Embedding 8B – AI Model Comparison | OpenRouter
- Qwen3 Embedding 8B vs BAAI/bge-m3 | Embedding Comparison – Agentset
- Comparative Analysis of Qwen-3 and BGE-M3 Embedding Models | Medium
- The guide to Qwen3-Embedding-8B | Alibaba – Zilliz
- The guide to bge-m3 | BAAI – Zilliz
- BGE M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity Text Embeddings
- Qwen/Qwen3-Embedding-8B · Hugging Face
- BAAI/bge-m3 · Hugging Face
Takeaway
- 벤치마크 1등 임베딩이 사내 규정 검색의 1등이 아닙니다.
- 희소 벡터와 다국어, GPU 예산을 한 표에 놓고 고르십시오.
- 두 모델을 동시에 표준으로 두지 마십시오. 컬렉션이 두 배가 됩니다.
- 결정 후에는 구현글(Qwen3 / BGE-M3) 하나만 따라 가십시오.