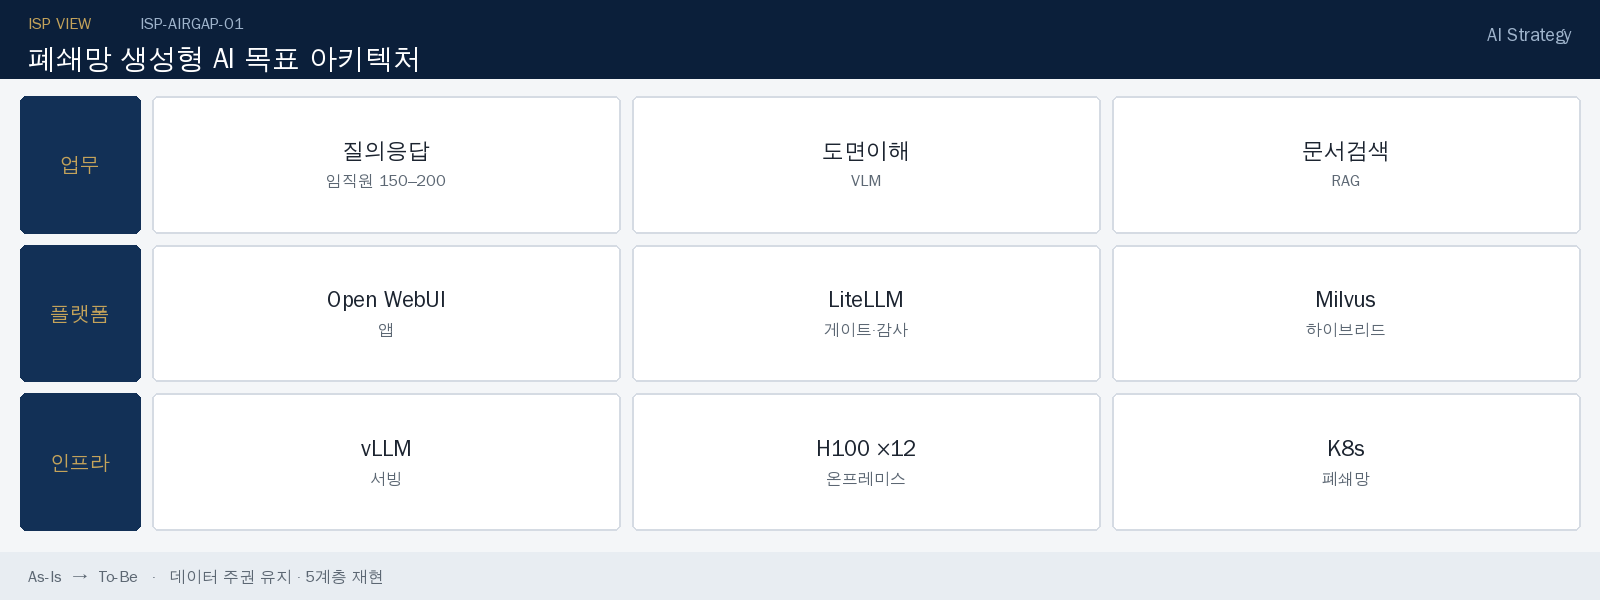
폐쇄망에서 150~200명이 쓰는 사내 생성형 AI, 설계부터 운영까지
저는 26년차 IT 컨설턴트이자 서울시립대학교 컴퓨터과학 박사과정에 있는 김영근입니다. 대기업 폐쇄망에 임직원 150~200명이 상시 쓰는 사내 생성형 AI 플랫폼을 제안·검토하면서 실제로 막혔던 지점만 이 글에 남깁니다. 모델 이름보다 먼저 갈리는 것은 라이선스, 반입, 프로브 시간, 그리고 검색입니다.
요구는 단순해 보였습니다. 데이터가 회사 밖으로 한 건도 나가지 않을 것, 텍스트 생성과 도면 이해와 사내 문서 질의응답을 한 화면에서 제공할 것, 가용 장비는 NVIDIA H100 12장과 Kubernetes 표준일 것. 동시 요청은 20~30건으로 잡았습니다. 상시 사용자 수와 실동시 요청은 다릅니다. 200명이 계정을 받아도 GPU를 동시에 붙잡는 수는 그보다 한 자릿수 작습니다. 그 숫자를 과장하면 하드웨어가 늘고, 줄이면 오후에 대기열이 생깁니다.
요구사항을 숫자로 고정하는 이유
| 항목 | 확정 값 | 현장에서 이렇게 읽습니다 |
|---|---|---|
| 망 | 완전 폐쇄망 | 런타임 다운로드가 한 번이라도 있으면 기동이 실패합니다 |
| 사용자 | 150~200명 상시 | 계정 수이지, GPU 동시 점유 수가 아닙니다 |
| 실동시 요청 | 20~30건 추정 | 서빙 엔진과 KV 캐시 예산을 이 구간에 맞춥니다 |
| 기능 | LLM + VLM + RAG | 채팅만 올리면 도면·규정 질의에서 바로 무너집니다 |
| 인프라 | H100 12장, Kubernetes | 데스크톱 앱을 서버에 올리는 우회는 심의에서 거절됩니다 |
이 다섯 줄이 합의되지 않으면 모델 비교표는 장식이 됩니다. 저는 착수 회의에서 이 표를 먼저 돌리고, 그다음에 도구를 이야기합니다.
LM Studio는 서버가 아닙니다
처음 검토한 조합은 Open WebUI + LM Studio + AnythingLLM이었습니다. 데모는 잘 됩니다. 노트북에서 채팅창이 뜨면 발주 부서는 “이미 있는 것 아니냐”고 묻습니다. 문제는 그다음입니다. LM Studio는 데스크톱 GUI 앱입니다. 헤드리스 운영, 재기동, 모니터링이 전제되어 있지 않습니다. GPU 서버에 올리는 순간 인프라 표준 심의에서 걸리고, llama.cpp 기반이라 동시 다중 사용자 처리량이 나오지 않습니다.
| 기준 | LM Studio | vLLM |
|---|---|---|
| 성격 | 로컬 실험용 GUI | 공용 추론 서빙 엔진 |
| 운영 | 헤드리스·재기동·관제가 전제되지 않음 | 컨테이너, 프로브, 메트릭이 전제됨 |
| 동시 사용자 | llama.cpp 경로, 다중 사용자에 약함 | PagedAttention, 연속 배칭 |
| 심의 | 공용 GPU 서버 표준과 충돌 | K8s 워크로드로 설명 가능 |
| 이 설계에서의 위치 | 개발자 개인 실험 | 전사 추론의 정본 |
LM Studio는 개발자 로컬 실험 도구로 포지셔닝하고, 공용 서비스 추론은 vLLM으로 갑니다. vLLM은 PagedAttention과 연속 배칭으로 동시 사용자 환경의 업계 표준이 된 서빙 엔진입니다.
이 한 줄을 합의하지 못하면 이후 설계가 전부 흔들립니다. 저는 제안서 본문이 아니라 인프라 심의 체크리스트에 이 문장을 먼저 넣습니다.
Open WebUI 라이선스는 착수 전에 합의합니다
Open WebUI는 50인 초과(30일 롤링 기준) 배포 시 “Open WebUI” 브랜딩(이름·로고)을 유지해야 합니다. 브랜딩을 유지하면 전사 무료 사용이 가능합니다. “OO사 AI 포털”처럼 화이트라벨링하려면 Enterprise 라이선스 계약이 필요합니다. 이 조건은 오픈 직전에 뒤집으면 법무와 홍보가 동시에 막힙니다.
착수 전 라이선스 합의 순서
- 예상 활성 사용자를 30일 롤링으로 잡습니다. 이 설계는 150~200명이므로 50인 초과가 분명합니다.
- 화면 상단 로고와 제품명을 유지할 수 있는지 홍보·법무에 확인합니다.
- 유지가 가능하면 라이선스 비용을 0으로 두고, 하드웨어에 예산을 모읍니다.
- 사명 포털로 바꿔야 하면 Enterprise 견적과 계약 일정을 착수 조건에 넣습니다.
- 합의 결과를 회의록에 남긴 뒤에야 UI 커스터마이징 범위를 엽니다.
브랜딩을 유지하는 전제라면 소프트웨어 라이선스와 외부 API 토큰 과금이 모두 0원입니다. 투자는 H100과 스토리지, 그리고 반입 인력에 집중됩니다. 이 숫자가 경영 보고에서 설득력을 갖습니다.
클라우드 5계층을 폐쇄망에 재현합니다
AWS Bedrock, Azure OpenAI 같은 상용 플랫폼은 공통적으로 다섯 계층으로 수렴했습니다. 애플리케이션, 오케스트레이션(게이트웨이·인증), 검색(RAG), 안전(가드레일·감사), 모델·데이터. 우리 설계는 이 패턴의 폐쇄망 구현체입니다. 구조를 새로 만들지 않습니다. 데이터가 머무는 위치만 바꿉니다.
| 계층 | 클라우드 (Bedrock 기준) | 본 설계 (폐쇄망) |
|---|---|---|
| 애플리케이션 | 자체 앱·Teams 연동 | Open WebUI · AnythingLLM |
| 오케스트레이션 | Bedrock API · IAM | LiteLLM Gateway · 사내 SSO |
| 검색(RAG) | Knowledge Bases | Qwen3-Embedding + Milvus 하이브리드 |
| 안전·감사 | Guardrails · CloudTrail | LiteLLM 감사로그 · 권한 필터 |
| 모델·데이터 | 사업자 서버의 모델 | 사내 H100의 GLM-5.2 · Qwen3-VL |
이 매핑은 경영 보고에서 “독자 설계가 아니라 글로벌 표준의 재현”이라는 논거가 됩니다. 보안 부서가 묻는 것은 모델 벤치마크가 아니라, 감사 로그가 어디에 남고 권한이 어느 계층에서 잘리는지입니다.
모델 선정, 벤치마크가 아니라 메모리와 문서 유형으로
모델 표는 쉽게 늘어납니다. 저는 세 가지 역할만 남겼습니다. 텍스트 생성, 이미지·도면 이해, 임베딩·리랭크. 한 모델이 세 역할을 겸하면 장애 때 전부 멈춥니다. 역할을 나누면 폴백이 생깁니다.
텍스트 생성: GLM-5.2, 그리고 INT4를 고른 이유
GLM-5.2는 총 743B 파라미터, 활성 39B의 MoE 모델입니다. 비유하면 743명 전문가 병원에서 질문마다 39명만 진료하는 구조입니다. 속도는 39B급입니다. 문제는 메모리가 743명 전원 출근 기준이라는 점입니다. FP8 가중치만 약 744GB입니다. H100 8장 합계 640GB에는 그대로 올라가지 않습니다.
그래서 INT4(4비트) 양자화를 택했습니다. 가중치가 약 400GB로 줄어 8장 안에 KV 캐시 여유까지 확보됩니다. 잘 만든 4비트 양자화는 체감 품질 저하가 크지 않다고 평가되지만, 저는 그 평가를 숫자로 가져오지 않습니다. 사내 골든셋으로 사전 검증한 뒤에만 도입하는 것을 조건으로 걸었습니다. 향후 H200을 들이면 FP8 원본 정밀도로 돌아가는 경로도 열어 두었습니다. INT4는 종착역이 아니라, 지금 가진 12장으로 서비스를 여는 수단입니다.
VLM: Qwen3-VL-30B-A3B
스캔 문서, 도면, 차트 캡처를 읽는 용도로는 Qwen3-VL을 선택했습니다. MoE 활성 3B라 H100 1장에 FP8로 여유 있게 돌고, Apache 2.0이라 라이선스가 깨끗합니다. 텍스트 대화도 가능하므로 메인 모델 점검 시 폴백 역할까지 겸합니다. 도면을 읽는 모델과 점검을 버티는 모델이 같으면, 예비 GPU를 하나 더 사는 것보다 싸게 연속성을 삽니다.
임베딩: Qwen3-Embedding-8B와 BGE-M3
| 항목 | Qwen3-Embedding-8B (채택) | BGE-M3 |
|---|---|---|
| 검색 품질 | MTEB 다국어 1위 — 상용 API를 상회한다는 평가 | 우수하나 최신 기준 열위 |
| Sparse(키워드) | 미지원 → Milvus 내장 BM25로 결합 | 모델이 Dense+Sparse를 동시에 출력 |
| 컨텍스트 | 32K — 긴 사내 문서에 유리 | 8K |
| 리랭커 | 같은 패밀리 Qwen3-Reranker-8B로 통일 | 별도 리랭커 조합이 필요 |
검색 정확도가 RAG 품질의 뿌리이므로 품질 우선으로 Qwen3-Embedding-8B를 택하고, 리랭커도 같은 패밀리로 맞췄습니다. 다만 임베딩 교체는 전체 재인덱싱입니다. 파일럿에서 두 모델을 사내 문서로 실측 비교한 뒤 확정하는 안전장치를 두었습니다. 공개 리더보드 1위가 부품번호·규정번호 재현율을 보장하지 않습니다. 비교 절차와 구현 메모는 Qwen3-Embedding 하이브리드 검색과 BGE-M3 하이브리드 검색에 따로 적었습니다.
H100 12장 배치 — 모델은 노드 안에, 가용성은 별도 장치로
대형 모델의 텐서 병렬(TP=8)은 NVLink로 묶인 같은 서버 8장 안에서 끝나야 합니다. 노드 간 분할(TP=16)은 400G 인터커넥트가 필요하고, 두 노드가 하나의 단일 장애점이 됩니다. 그래서 배제했습니다. 12장을 고르게 나누는 그림은 보기 좋지만, NVSwitch가 없는 구간을 넘기는 순간 지연과 장애 반경이 같이 커집니다.
| 위치 | GPU | 워크로드 |
|---|---|---|
| HGX 노드 (SXM·NVSwitch) | 8 | GLM-5.2 INT4 · vLLM TP=8 · MTP 투기적 디코딩 |
| PCIe 서버 | 2 | Qwen3-VL FP8 × 2 replica (이미지 + 폴백) |
| PCIe 서버 | 1 | Qwen3-Embedding-8B + Reranker (MIG 분할) |
| PCIe 서버 | 1 | 배치 인덱싱 · 신모델 검증 예비 |
12장 구성은 메인 모델이 단일 인스턴스라는 리스크를 안습니다. 이를 숨기지 않고 네 가지 보완 장치를 설계했습니다.
- LiteLLM 자동 폴백 — GLM 이상 시 Qwen3-VL로 즉시 전환합니다.
- 야간·주말 계획 점검 윈도우 — 가중치 교체와 드라이버 작업을 여기로 모읍니다.
- NVMe 로컬 캐시 — NFS에서 매번 읽지 않게 해 재기동을 줄입니다.
- VLM 2 replica — 폴백이 걸려도 이미지 질의와 텍스트 대체를 동시에 받습니다.
Kubernetes 매니페스트는 replicas 숫자만 바꿔 이중화로 넘어가게 미리 짰습니다. 2차년도에 HGX 노드를 증설하면 구조 변경 없이 무중단 체계로 올라가는 경로입니다. 지금 12장으로 완벽을 주장하지 않습니다. 지금 열고, 다음 노드가 들어왔을 때 같은 YAML로 커지게 합니다.
Kubernetes와 vLLM, 대형 모델이 실제로 뜨는 지점
설계가 끝나도 클러스터에서 모델이 뜨지 않으면 서비스가 없습니다. 이 구간에서 저는 번들 이미지 누락, 프로브 시간, 가중치 볼륨, 노드 오염 네 가지를 먼저 봅니다.
NVIDIA GPU Operator
드라이버, device plugin, DCGM을 Operator로 일괄 관리합니다. 폐쇄망에서는 Operator 구성 이미지 전체를 Harbor에 미러링해야 합니다. 이미지 수가 많아 누락이 가장 잦은 구간입니다. 메인 모델 이미지만 반입하고 Operator 부속 이미지를 빼먹으면, GPU를 보는 Pod가 Pending에서 벗어나지 않습니다. 체크리스트에 “모델 가중치”만 있고 “Operator 종속 이미지”가 없으면 반입은 끝난 것이 아닙니다.
vLLM 기동 옵션
| 플래그 | 값 | 이유 |
|---|---|---|
| –tensor-parallel-size | 8 | HGX 8장을 한 인스턴스로 묶습니다. 노드를 넘기지 않습니다 |
| –max-model-len | 131072 | 컨텍스트는 1M이 아니라 128K입니다. KV 캐시가 예산 안에 들어야 합니다 |
| –enable-prefix-caching | 사용 | 시스템 프롬프트와 RAG 접두가 반복됩니다 |
| MTP 투기적 디코딩 | 사용 | 활성 39B 경로의 체감 지연을 줄이는 수단입니다 |
1M 컨텍스트는 소개 자료에서 잘 팔립니다. H100 8장 INT4 위에서는 KV 캐시가 먼저 예산 밖으로 나갑니다. 128K로 자르면 사내 규정·회의록·도면 설명은 대부분 들어갑니다. 더 긴 문서는 청킹과 검색이 담당합니다. 컨텍스트를 키우는 것은 나중에 GPU가 늘었을 때의 일입니다.
startupProbe는 30분
743B 모델 로딩에 10분 이상 걸립니다. 기본 프로브면 로딩 중에 재시작 루프에 빠집니다. 로그에는 계속 “시작 중”만 남고, 운영자는 이미지가 깨졌다고 착각합니다. startupProbe를 30분으로 넉넉히 줍니다. liveness는 로딩이 끝난 뒤에만 살아 있게 합니다. 이 한 줄이 구축 첫째 주의 밤을 좌우합니다.
볼륨, taint, 상태 저장소
모델 가중치는 hostPath 대신 NFS/CephFS ReadOnlyMany PVC로 붙입니다. 노드가 재스케줄되면 hostPath는 사라집니다. PVC면 다른 GPU 노드로 옮겨도 같은 가중치를 읽습니다. HGX 노드에는 taint를 걸어 GLM 전용으로 고정합니다. 서비스 계층 — Open WebUI ×2, Postgres, Redis, Milvus — 은 별도 노드입니다. SQLite와 내장 벡터DB는 다중 replica에서 반드시 깨집니다. 처음부터 외부화합니다.
서빙을 올리는 순서
- Harbor에 GPU Operator 전체 이미지와 vLLM, UI, DB 이미지를 미러링합니다.
- GPU Operator를 설치하고 DCGM이 12장을 모두 보는지 확인합니다.
- HGX 노드에 taint/toleration을 걸고, 서비스 노드와 분리합니다.
- 가중치 PVC를 ReadOnlyMany로 마운트하고 SHA256을 대조합니다.
- vLLM을 TP=8, max-model-len 131072, prefix caching으로 기동합니다.
- startupProbe 30분을 적용하고, 준비 완료 전에 트래픽을 붙이지 않습니다.
- Open WebUI를 2 replica로 올리고 Postgres·Redis·Milvus에 연결합니다.
- LiteLLM을 앞에 두고 모델 별칭과 폴백을 등록합니다.
폐쇄망 반입의 세 가지 함정
폐쇄망 구축 실패의 대부분은 모델이 아니라, 컨테이너가 몰래 인터넷을 찾다 죽는 데서 옵니다. 가중치는 이미 들어왔는데 기동이 실패하면, 보안 부서는 “아직 외부로 나간다”고 판단합니다. 그 판단은 틀리지 않습니다.
| 함정 | 증상 | 차단 |
|---|---|---|
| Open WebUI 기본 RAG 임베딩 | 기동 시 Hugging Face에서 모델을 받으려 합니다 | 외부 vLLM 임베딩 엔드포인트를 지정합니다 |
| tiktoken | BPE 파일을 다운로드하려 합니다 | 캐시 디렉터리를 사전 반입합니다 |
| 허깅페이스 허브 호출 | 기동 타임아웃으로 죽습니다 | 전 컨테이너에 HF_HUB_OFFLINE=1, TRANSFORMERS_OFFLINE=1을 강제합니다 |
반입 후 증거 만드는 순서
- 모델 가중치와 토크나이저, tiktoken 캐시, 컨테이너 이미지를 목록으로 확정합니다.
- 각 파일의 SHA256을 외부망에서 계산해 반입 문서에 붙입니다.
- 내부에서 해시를 다시 대조하고 나서야 레지스트리에 올립니다.
- 환경 변수 오프라인을 강제하고, Open WebUI가 내부 임베딩만 보게 합니다.
- 기동 후 tcpdump로 외부 통신 시도 0건을 실측합니다.
- 그 캡처를 보안 심의 자료로 남깁니다. “데이터가 나가지 않는다”는 주장이 증거가 됩니다.
반입 심의가 크리티컬 패스입니다. GPU가 이미 들어와 있어도, 목록이 확정되지 않으면 주차가 밀립니다. 착수 첫 주에 반입 목록을 닫지 않으면 16주 계획은 종이입니다.
RAG는 생성 모델이 아니라 검색에서 갈립니다
사내 질의응답이 실패하는 이유는 대부분 GLM이 멍청해서가 아닙니다. 조항이 잘린 청크, 개정 전 문서, 권한이 다른 부서 자료가 섞여 들어갑니다. 검색 설계를 대충 두면 생성 모델은 자신 있게 틀린 답을 씁니다. 파이프라인 일반론은 Advanced RAG에도 적었습니다. 여기서는 이 플랫폼에 실제로 올린 경로만 말합니다.
인덱싱
수집 → 파싱(스캔본은 VLM으로 OCR) → 청킹 → 임베딩 → Milvus 저장. 경험상 청킹 전략이 정답률의 절반입니다. 표나 조항이 중간에 잘리면 검색이 실패합니다. 규정은 조·항 단위, 매뉴얼은 절차 단위, 도면은 캡션과 번호 단위로 나눕니다. 이 규칙은 파일럿에서 문서 유형별로 튜닝해야 합니다. 부서, 보안등급, 개정일을 메타데이터로 같이 넣어야 권한 필터와 최신본 우선이 됩니다.
질의 파이프라인
질문은 좌표화됩니다. 의미 검색(Dense)과 키워드 검색(Milvus 내장 BM25)을 병렬로 돌리고, RRF로 후보 20~50개를 결합합니다. Qwen3-Reranker가 3~5개로 재정렬합니다. GLM-5.2는 그 근거 문서로만 답하고 출처를 각주로 붙입니다. 부품번호·규정번호가 많은 사내 기술문서에서 의미 검색만 쓰면 번호가 비슷한 조항을 놓칩니다. 하이브리드가 선택이 아니라 필수인 이유입니다.
| 단계 | 동작 | 산출 |
|---|---|---|
| 1 | 질문 임베딩 + 키워드 분석 | Dense 쿼리, BM25 쿼리 |
| 2 | 밀버스 병렬 검색 | 두 리스트 |
| 3 | RRF 결합 | 후보 20~50개 |
| 4 | Qwen3-Reranker | 최종 3~5개 |
| 5 | GLM-5.2 + 출처 각주 | 근거 범위 안의 답 |
골든셋 100문항
실제 사내 질문 100문항의 골든셋을 만듭니다. 정답 충실도와 검색 재현율을 수치로 관리하고, 모델·설정 변경 시 회귀평가 통과를 배포 관문으로 명문화합니다. “근거에 없으면 모른다고 답하라”는 시스템 지침과 출처 표시 의무화가 환각 방지의 기본기입니다. 100문항은 마케팅 숫자가 아닙니다. 규정, 부품, 인사, 보안, 도면이 섞여야 하고, 정답 문서 ID를 사람이 먼저 찍어야 합니다. 그 표가 없으면 INT4 전환도, 청킹 변경도 감으로 배포하게 됩니다.
LiteLLM은 모든 요청의 관제탑입니다
채팅 UI, 지식베이스, 사내 시스템이 모델을 직접 부르지 않습니다. 모든 호출이 LiteLLM 게이트웨이 하나를 경유합니다. 라우팅과 부하 분산, 메인 모델 이상 시 수 초 내 폴백, 부서별 API 키와 사용량 한도, 감사 로그 일원화가 여기 모입니다.
이 구조의 가치는 모델을 교체·증설해도 사용자 화면과 연동 시스템을 고치지 않는다는 점입니다. GLM을 점검하는 낮에도 별칭은 그대로입니다. 게이트웨이가 Qwen3-VL로 넘깁니다. 부서 키가 없으면 호출 자체가 거절되므로, 사후 로그 조회가 아니라 사전 차단이 됩니다. 폐쇄망에서 감사는 “나중에 찾아보는 파일”이 아니라 “지금 막히는 정책”이어야 합니다.
n8n과 LangGraph는 대체 관계가 아닙니다
업무 자동화를 넓히면서 n8n을 검토했습니다. 페어코드 라이선스이고, 사내 자체 호스팅·내부 사용은 무료입니다. 기존 LangGraph 백엔드를 들어내자는 의견이 나왔습니다. 결론은 전면 대체가 아닙니다. 경계선을 긋는 역할 분담입니다.
| 기준 | n8n | LangGraph |
|---|---|---|
| 실행 방식 | 비동기·이벤트·스케줄 | 동기·실시간 응답, 스트리밍 필수 |
| 흐름 복잡도 | 선형~단순 분기 + 사람 승인(HITL) | 순환·상태 머신·서브그래프 |
| 수정 주체 | 운영·현업, 코드 배포 없이 | 개발팀, 테스트·CI 필수 |
| 이 설계에서의 위치 | 인덱싱, 브리핑, 회의록, 결재 사전검토 | 실시간 RAG·에이전트 코어 |
문서 인덱싱 자동화, 일일 브리핑, 회의록 처리, 결재 사전검토 같은 비동기 파이프라인은 n8n으로 옮기면 트리거·재시도·승인 UI가 내장이라 코드가 통째로 사라집니다. 반면 200명이 동시에 치는 실시간 RAG 경로에 n8n을 끼우면 실행 오버헤드가 응답 시간에 얹히고 토큰 스트리밍도 불가능합니다.
둘을 적대 관계로 두지 않습니다. n8n이 LangGraph API를 하나의 노드로 호출합니다. 통합과 트리거는 n8n, 핵심 에이전트 로직은 LangGraph입니다. 대외 발송·결재처럼 영향이 큰 단계에는 사람 승인 노드를 반드시 넣습니다. 표준 문장은 짧습니다. AI가 제안하고, 사람이 결정합니다.
16주 이행, 크리티컬 패스는 반입입니다
| 구간 | 기간 | 산출 |
|---|---|---|
| 반입·기반 | 4주 | 이미지·가중치·캐시 목록, Harbor, GPU Operator, 해시와 오프라인 환경 변수 |
| 서빙 구축·부하시험 | 4주 | vLLM TP=8, 30분 프로브, 20~30 동시 요청 구간 확인, 폴백 전환 |
| 서비스 통합·RAG 품질 | 4주 | Open WebUI, LiteLLM, 하이브리드 검색, 골든셋 100 회귀 관문 |
| 파일럿·전사 오픈 | 4주 | 부서 파일럿, SSO, 사용량 한도, 점검 윈도우 운영 이관 |
- 착수 즉시 반입 목록을 확정합니다. 모델보다 Operator 이미지가 먼저입니다.
- 라이선스 브랜딩과 SSO 연동 범위를 같은 주에 닫습니다.
- 서빙이 뜬 뒤 부하를 20~30 동시 요청 구간에 맞춰 보고, 그 이상 숫자를 약속하지 않습니다.
- 골든셋 100이 통과하기 전에는 전사 공지를 내지 않습니다.
- 이후 모델·이미지 업데이트는 분기 릴리스 캘린더로 정례화합니다. 수시 반입은 심의를 다시 깨뜨립니다.
이 구성의 본질은 초기 투자 최소화와 서비스 연속성의 균형입니다. 브랜딩 유지 전제라면 소프트웨어 라이선스 0원, 외부 API 토큰 과금 0원입니다. 투자는 하드웨어에 모이고, 표준 API 구조 덕분에 분기마다 나오는 신모델에도 구조를 바꾸지 않고 대응할 수 있습니다.
폐쇄망 LLM을 검토 중이라면 모델 선택보다 먼저 반입 절차, 오프라인 함정, 라이선스 조건을 확인하시기 바랍니다. 설계 질문이나 교정은 문의하기로 남겨 주시면 아는 범위에서 답하겠습니다. 운영자 소개는 소개에 있습니다.
Takeaway
- LM Studio는 로컬 실험 도구입니다. 150~200명 공용 추론은 vLLM입니다.
- Open WebUI는 50인 초과에서 브랜딩 유지 또는 Enterprise 계약이 필요합니다. 착수 전에 합의합니다.
- Bedrock과 같은 5계층을 폐쇄망에 재현합니다. 설득 포인트는 데이터 주권입니다.
- GLM-5.2는 743B/활성 39B입니다. H100 8장에는 INT4(약 400GB)로 올리고, 컨텍스트는 128K로 자릅니다.
- H100 12장은 8+2+1+1입니다. 메인 단일 인스턴스 리스크는 폴백, 점검 창, 캐시, VLM 2 replica로 받습니다.
- startupProbe 30분을 주지 않으면 743B 로딩이 재시작 루프에 빠집니다.
- 반입 실패는 모델이 아니라 Hugging Face, tiktoken, 오프라인 플래그에서 납니다. tcpdump 0건이 증거입니다.
- RAG는 BM25+Dense+Rerank입니다. 배포 관문은 골든셋 100문항입니다.
- LiteLLM이 별칭과 감사를 가져가면 모델 교체가 화면 교체가 되지 않습니다.
- n8n은 비동기와 승인, LangGraph는 실시간 코어입니다. 핫 패스에 워크플로 도구를 끼우지 않습니다.