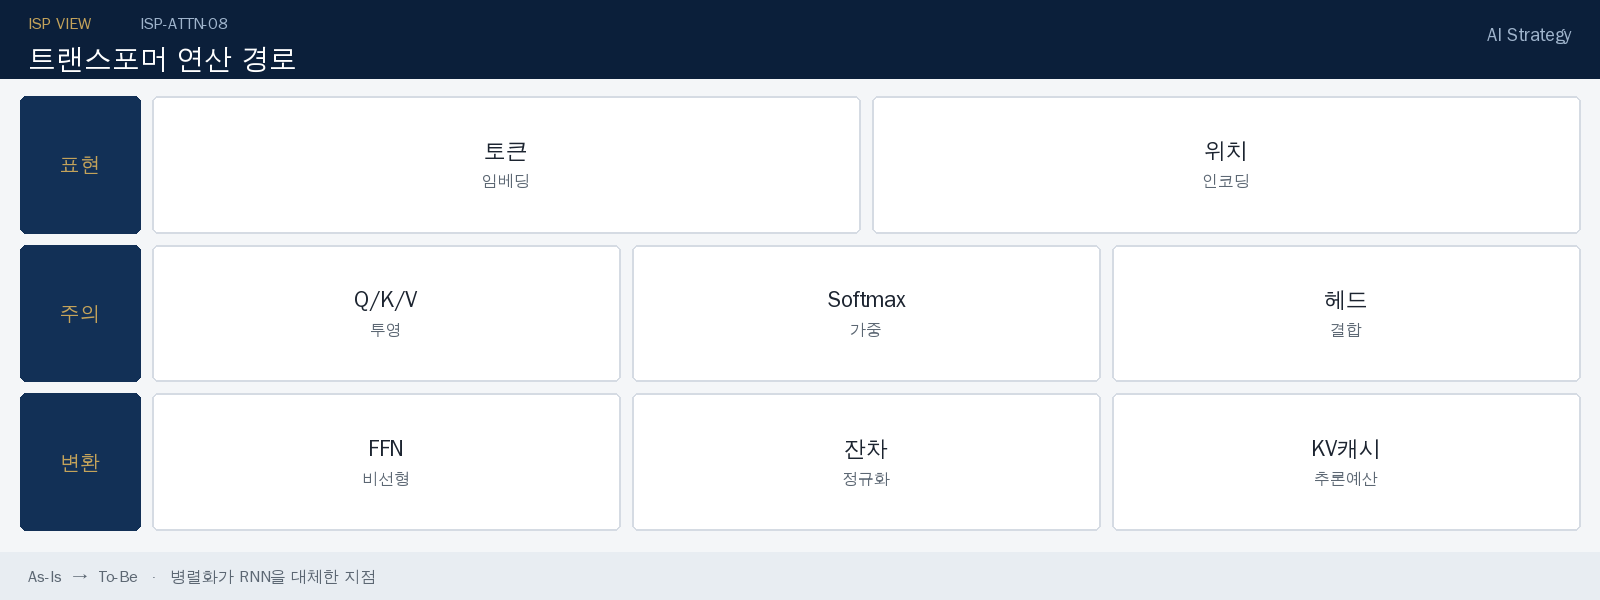
왜 다시 RNN 대 Transformer인가
2017년 “Attention Is All You Need” 논문 이후 거의 모든 대형 언어모델이 Transformer 계열입니다. 신입 개발자들은 처음부터 Transformer만 배우다 보니, 정작 왜 RNN이 밀려났는지, 그리고 Attention이 정확히 어떤 계산을 대신하는지를 건너뛰는 경우가 많습니다. 이 글은 논문 리뷰가 아니라, 실제로 시퀀스 모델링 아키텍처를 선택하거나 파인튜닝 전략을 짤 때 필요한 구현자 관점의 이해를 정리한 것입니다.
RNN이 실패하는 지점은 정확도가 아니라 구조입니다
RNN(그리고 LSTM·GRU)의 근본적인 한계는 정확도 문제가 아니라 계산 구조 문제입니다. RNN은 은닉 상태 h_t를 h_(t-1)로부터 순차적으로 계산합니다. 즉 4번째 토큰의 표현을 구하려면 1, 2, 3번째를 반드시 순서대로 거쳐야 합니다. 이 순차성이 두 가지 문제를 낳습니다. 첫째, GPU의 병렬 연산 능력을 활용할 수 없어 시퀀스가 길어질수록 학습 시간이 선형으로 늘어납니다. 둘째, 먼 거리의 토큰 간 관계를 학습하려면 그 사이의 모든 은닉 상태를 거쳐 정보가 전달되어야 하는데, 이 경로가 길어질수록 그래디언트가 소실되거나 폭발합니다. LSTM의 게이트 메커니즘은 이 문제를 완화했을 뿐 근본적으로 없애지는 못했습니다.
Self-Attention이 대신하는 계산
Transformer의 핵심은 순환 없이 시퀀스 내 모든 위치가 서로를 직접 참조하게 만드는 것입니다. 각 토큰은 Query, Key, Value 세 벡터로 투영되고, Query와 모든 Key의 내적으로 유사도를 구한 뒤 softmax로 정규화해 Value를 가중합합니다.
Attention(Q, K, V) = softmax(QK^T / sqrt(d_k)) V

# 의사코드
Q = X @ W_q          # (seq_len, d_k)
K = X @ W_k           # (seq_len, d_k)
V = X @ W_v           # (seq_len, d_v)
scores = Q @ K.T / sqrt(d_k)   # (seq_len, seq_len)
weights = softmax(scores, axis=-1)
output = weights @ V   # (seq_len, d_v)
이 계산 전체가 행렬 곱셈이기 때문에 GPU에서 한 번에 병렬 처리됩니다. RNN처럼 이전 시점을 기다릴 필요가 없습니다. sqrt(d_k)로 나누는 것은 내적 값이 차원이 커질수록 커져서 softmax가 한쪽으로 치우치는 것을 막기 위한 스케일링입니다.
| 구분 | RNN/LSTM | Transformer (Self-Attention) |
|---|---|---|
| 토큰 간 정보 전달 | 순차적, 인접 시점을 거쳐 전달 | 모든 위치가 한 번에 직접 참조 |
| 병렬화 | 시퀀스 내에서는 불가능 | 행렬 연산으로 완전 병렬 |
| 장거리 의존성 | 경로 길이에 비례해 그래디언트 소실 | 경로 길이 O(1), 직접 연결 |
| 연산 복잡도 | O(n · d²) — 시퀀스 길이에 선형 | O(n² · d) — 시퀀스 길이에 제곱 |
| 순서 정보 | 순환 구조 자체가 순서를 인코딩 | 위치 인코딩을 별도로 더해야 함 |
Multi-Head Attention과 잔차 연결 — 왜 하나로는 부족한가
Self-Attention 하나만으로는 표현력에 한계가 있어, 실제 Transformer는 Query/Key/Value 투영을 여러 개(예: 8~96개 head)로 나누어 병렬로 계산한 뒤 결과를 이어 붙입니다. 각 head는 서로 다른 초기화에서 출발해 학습 과정에서 서로 다른 관계(구문 구조, 장거리 참조, 국소 패턴 등)에 집중하도록 분화됩니다. 이렇게 얻은 결과는 곧바로 다음 층으로 넘어가지 않고, 입력값을 그대로 더하는 잔차 연결(residual connection)과 층 정규화(layer normalization)를 거칩니다. 잔차 연결이 없으면 층이 깊어질수록(GPT·BERT 계열은 수십 층) 그래디언트가 소실되어 학습이 사실상 멈춥니다. “Attention만 이해하면 Transformer를 이해한 것”이라는 생각이 위험한 이유가 여기에도 있습니다 — 잔차 연결과 정규화 없이는 애초에 층을 쌓을 수 없습니다.
위치 인코딩 방식 비교 — 절대 위치부터 RoPE까지
| 방식 | 원리 | 장단점 |
|---|---|---|
| 사인·코사인 절대 위치 (원 논문) | 위치마다 고정된 주기 함수 값을 임베딩에 더함 | 구현이 단순하지만 학습 시 본 길이를 넘으면 성능이 급격히 떨어짐 |
| 학습형 절대 위치 | 위치별 임베딩을 파라미터로 학습 | 학습 길이 내에서는 성능이 좋으나 길이 확장이 근본적으로 어려움 |
| RoPE (Rotary Position Embedding) | Query·Key 벡터를 위치에 따라 회전시켜 상대 위치 정보를 내적에 자연스럽게 반영 | 길이 확장(스케일링)에 유리해 현재 주요 LLM 대부분이 채택. 단 base·스케일 변경 시 기존 체크포인트와 호환되지 않음 |
| ALiBi | Attention 스코어에 거리 비례 페널티를 직접 더함 | 추가 파라미터 없이 길이 외삽에 강하지만 채택 모델이 상대적으로 적음 |
구현에서 놓치기 쉬운 두 가지
Self-Attention은 집합 연산이라 토큰 순서를 그 자체로는 구분하지 못합니다. “고양이가 개를 쫓는다”와 “개가 고양이를 쫓는다”가 Attention 계산만 놓고 보면 동일하게 취급될 수 있다는 뜻입니다. 이를 보완하기 위해 임베딩에 위치 인코딩(사인·코사인 함수 기반, 또는 학습 가능한 파라미터)을 더해 순서 정보를 주입합니다. 두 번째로, 하나의 Attention만 쓰면 표현력이 제한되므로 여러 개의 Attention을 병렬로 두고(Multi-Head Attention) 각 head가 서로 다른 표현 부공간(구문 관계, 의미 관계 등)에 집중하도록 학습시킵니다. 이 두 요소를 빼고 “Self-Attention = Transformer”로 단순화해서 이해하면, 왜 처음부터 위치 인코딩을 넣지 않으면 모델이 아예 어순을 학습하지 못하는지 설명할 수 없습니다.
한계와 제언
Transformer가 만능은 아닙니다. Self-Attention의 연산량은 시퀀스 길이의 제곱에 비례하므로(O(n²)), 문서 전체나 긴 로그를 통째로 넣으면 메모리와 연산 비용이 급격히 늘어납니다. 이 문제 때문에 FlashAttention 같은 메모리 효율화 기법, 슬라이딩 윈도우·희소 Attention 같은 구조적 근사, 그리고 Mamba 같은 State Space Model 계열이 다시 순차 처리에 가까운 방식으로 긴 시퀀스를 다루려는 시도를 이어가고 있습니다. 실무에서는 “Transformer가 항상 낫다”가 아니라, 시퀀스 길이가 짧고 지연시간이 중요한 온디바이스 추론 같은 상황에서는 여전히 경량 RNN이나 SSM 계열이 유효한 선택지일 수 있다는 점을 열어 두는 것이 맞습니다.
FlashAttention이 실제로 줄이는 것
FlashAttention은 Attention의 수학적 결과를 바꾸지 않고, GPU 메모리 계층(HBM과 SRAM) 사이의 이동을 줄이는 방식으로 속도와 메모리 사용량을 개선합니다. 표준 구현은 seq_len × seq_len 크기의 attention score 행렬을 통째로 HBM에 써야 하지만, FlashAttention은 이 행렬을 작은 블록 단위로 쪼개 SRAM 안에서 계산을 끝내고 최종 결과만 기록합니다. 같은 정확도를 유지하면서 긴 컨텍스트를 다룰 때의 메모리 병목을 크게 완화하는 이유입니다.
구현자가 실제로 재는 세 숫자
논문을 다시 읽는 이유는 수식을 외우기 위해서가 아닙니다. 서빙 예산을 잡기 위해서입니다. 프리필(프롬프트 전체를 한 번에 넣는 구간)과 디코드(토큰을 하나씩 뽑는 구간)는 병목이 다릅니다. 프리필은 행렬 곱이 크고, 디코드는 KV 캐시 읽기가 커집니다. 컨텍스트를 8k에서 32k로 올리면 정확도가 아니라 캐시 용량과 TTFT가 먼저 움직입니다.
| 측정 | 무엇을 보나 | 자주 하는 착각 |
|---|---|---|
| TTFT | 첫 토큰까지 시간 | 토큰/초만 보고 체감 지연을 무시 |
| TPOT | 이후 토큰 간격 | 배치를 키우면 무조건 좋아진다고 봄 |
| KV 바이트 | 레이어×헤드×길이×정밀도 | 컨텍스트 한도를 모델 카드 숫자로만 잡음 |
서빙 비용을 줄이는 실전 기법 — 양자화와 캐시 관리
동시 사용자가 늘어나면 KV 캐시가 GPU 메모리를 먼저 채웁니다. 실무에서 흔히 쓰는 완화책은 세 가지입니다.
- 양자화(Quantization): 가중치와 KV 캐시를 FP16에서 INT8·INT4로 낮춰 메모리 사용량을 절반 이상 줄입니다. 정확도 손실은 태스크·모델에 따라 다르므로 반드시 자체 골든셋으로 검증해야 합니다.
- 캐시 페이징(PagedAttention 등): KV 캐시를 고정 크기 블록으로 관리해 메모리 단편화를 줄이고, 여러 요청이 캐시를 더 효율적으로 공유하게 합니다.
- 질의 길이 상한: 모델 카드의 최대 컨텍스트를 그대로 서비스 한도로 쓰지 않고, 실제 동시 사용자 수와 평균 입력 길이를 곱해 GPU 메모리 예산 안에 들어오는 실질 한도를 별도로 산정합니다.
위치 인코딩을 나중에 바꾸지 못하는 이유
사인·코사인 절대 위치는 학습 길이를 넘기면 바로 흔들립니다. RoPE는 상대 각도로 길이를 늘리기 쉽지만, base와 스케일을 바꾼 뒤에는 기존 체크포인트와 같은 공간이 아닙니다. 사내 RAG에서 “컨텍스트만 늘리면 조항이 더 붙는다”고 했다가, 위치 스케일만 바꾸고 임베딩·생성 모델을 그대로 둔 채 평가하면 순위가 무너집니다. 길이 확장은 별도 골든셋으로 다시 재야 합니다.
슬라이딩 윈도우나 희소 어텐션은 긴 로그에 유효합니다. 다만 윈도우 밖에 있는 부품번호는 존재하지 않는 토큰이 됩니다. 규정 조항처럼 앞 정의를 뒤에서 가리키는 문서는 창을 키우기 전에 청크 경계와 교차 참조를 먼저 고칩니다. 온디바이스에서 지연이 우선이면 GRU나 작은 SSM이 아직 후보입니다. “트랜스포머가 항상 이긴다”는 학습 처리량 이야기이지, 50ms SLA 이야기와는 층이 다릅니다.
사내 생성형 AI 파일럿에서 제가 먼저 묻는 것은 “어텐션을 이해했는가”가 아니라, 동시 사용자 수와 평균 입력 길이입니다. 150명이 규정 질의를 8k로 던지면 KV가 먼저 찹니다. 그때 선택지는 양자화, 캐시 페이징, 질의 길이 상한입니다. 모델 교체는 그 다음입니다.
Takeaway
- RNN의 한계는 정확도가 아니라 순차 계산 구조 자체이며, 이 때문에 병렬화가 불가능하고 장거리 의존성 학습이 어렵습니다.
- Self-Attention은 QK^T/sqrt(d_k) 스케일링과 softmax 가중합으로 모든 토큰이 직접 서로를 참조하게 만드는 행렬 연산입니다.
- 위치 인코딩과 Multi-Head Attention 없이는 순서 정보와 다양한 관계 표현을 모두 잃습니다.
- 잔차 연결과 층 정규화 없이는 수십 층을 쌓는 것 자체가 불가능합니다.
- Transformer의 O(n²) 복잡도는 여전한 한계이며, 시퀀스가 매우 길거나 온디바이스 제약이 있다면 대안 아키텍처를 검토할 가치가 있습니다.
- 서빙 단계에서는 양자화·캐시 페이징·질의 길이 상한이 모델 교체보다 먼저 검토할 실전 대응입니다.