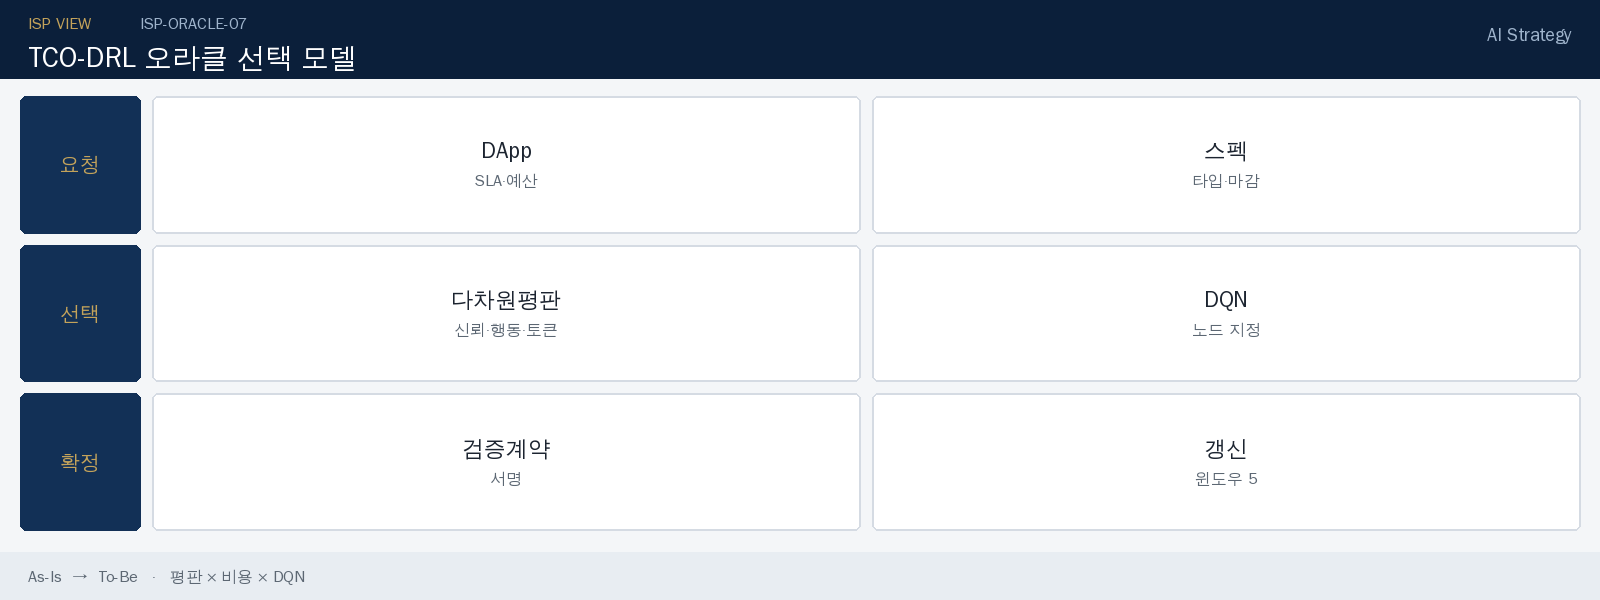
오라클을 DQN으로 고른다는 것
기업 블록체인 설계를 오래 하다 보면, 제안서의 합의 알고리즘보다 먼저 깨지는 지점이 있습니다. 스마트 계약이 체인 밖 가격, 센서, 물류 상태, 전력 계량값을 누가, 어떤 비용으로, 얼마나 최근에 믿을 만하게 넣어 주는가입니다. 그 주체를 오라클이라고 부릅니다. 오라클이 틀리면 계약은 틀린 사실을 정직하게 실행합니다. 합의가 강한 체인이라도 입력 한 줄이 약하면 그 강함은 반대 방향으로 작동합니다.
화북전력대학·산서대학 연구진의 TCO-DRL 논문은 그 입력을 “평판이 높은 노드”에 맡기지 않고, 다차원 신뢰 점수와 딥 강화학습으로 매 요청마다 고르자고 합니다. 저는 블록체인·보안 현장에서 오라클을 중계 서버나 TEE 한 줄로 처리한 구성을 여러 번 봤고, 박사과정에서 같은 주제를 논문으로 읽고 있습니다. 그래서 이 글을 번역 연재가 아니라 실무자가 베낄 항목과 버려야 할 수치를 가리는 읽기로 다시 씁니다. 이전에 1/3·2/3·3/3으로 쪼개 두었던 요약은 이 글로 합칩니다.
이 논문을 읽은 이유
한국 기업·공공 체인에서 오라클은 대체로 세 갈래로 등장합니다. 하나는 Chainlink 같은 상용 피드를 붙이는 것이고, 하나는 자체 중계 서버를 오라클이라고 부르는 것이며, 하나는 제안서에 Intel SGX 같은 TEE를 한 줄 넣는 것입니다. 현장 검토에서 반복해서 비는 칸은 노드가 배신한 뒤 얼마나 빨리 제외되는가, 그리고 비싼 고평판 노드만 고르면 운영비가 감당되는가입니다.
TCO-DRL의 저자 소속은 제어·컴퓨터공학과이고, 연구비는 분산 에너지 저장의 계통 연계입니다. 스마트그리드·공급망·IoT 체인을 다루는 한국 프로젝트와 문제 설정이 맞닿아 있습니다. 가격 피드 DeFi 논문이 아니라, 요청이 늘고 노드 품질이 들쭉날쭉한 커뮤니티에서 누구를 고를지를 최적화 문제로 바꾼 글입니다. 그 점이 번역 요약보다 먼저 읽을 가치가 있었습니다.
오라클 문제는 “외부 데이터를 가져오는 모듈”이 아닙니다. 체인 합의가 보장하지 않는 사실을 누가 서명하는가, 그 서명의 최근 이력이 얼마인가의 문제입니다.
실무 언어로 본 문제
스마트 계약은 격리되어 있습니다. 거래소 시세, 창고 온도, 계통 주파수, 웹 API 응답을 직접 읽지 못합니다. 오라클이 수집·검증·전달을 맡습니다. 이론상 오라클은 중립이어야 하지만, 운영 주체는 사람·회사·스크립트입니다. 자기 이익으로 값을 밀거나, 장애로 늦은 값을 넣거나, 담합으로 다수결을 만들 수 있습니다. 계약은 그 값을 사실로 취급합니다.
기존 대응은 크게 두 줄입니다.
| 방식 | 대표 사례 | 현장에서 깨지는 지점 |
|---|---|---|
| TEE·하드웨어 증명 | Intel SGX, Towncrier, Provable, TLS Notary | 엔클레이브는 입력받은 값을 서명할 뿐입니다. 소스 자체가 틀리면 서명은 틀린 값을 보증합니다. 수동 입력·비디지털 데이터에는 맞지 않고, SGX 쪽채널·공급망 가정도 남습니다. |
| 평판 점수 | Chainlink, Witnet, Augur | 온체인 응답 지연, 성공/실패, 다수결 일치처럼 과거 기록에 기대는 경우가 많습니다. 오래 착실하다가 한 번에 배신하거나, 간헐적으로만 거짓말하는 노드를 늦게 봅니다. |
여기에 비용이 겹칩니다. 평판이 높은 노드는 대체로 비싸고, DApp 요청이 늘면 “매번 최고 평판만”은 예산이 아닙니다. BLOR은 베이지안 다중팔 도적(Bayesian multi-armed bandit)으로 노드를 고릅니다. 사전 분포를 두고 성공/실패를 갱신하는 방식이라, 요청 복잡도·서비스 종류·최근 행동·비용이 동시에 움직이는 상태 공간에는 공간이 좁습니다. TCO-DRL은 그 빈칸을 다차원 평판과 DQN으로 메우겠다는 제안입니다.
모델이 실제로 하는 일
시스템 구성은 DApp(데이터 요청자), 오라클 커뮤니티, 외부 데이터 소스입니다. 커뮤니티 안에는 노드뿐 아니라 모니터링 모듈과 평판 모듈이 있고, 선택은 DQN이 담당합니다. 온체인에는 계약 네 개가 나뉩니다.
| 구성 | 논문에서의 역할 | 기업 체인에서 대응하는 것 |
|---|---|---|
| 등록 계약 | 요청자·계정 등록 | 참여자 온보딩, 키·식별자 등록 |
| 요청 계약 | 데이터 요구, 마감, 부가 서비스 조건 | 쿼리 스펙과 SLA |
| 호출 계약 | DRL 모델을 불러 노드를 지정 | 오프체인 셀렉터 + 온체인 지정 기록 |
| 검증 계약 | 서명과 데이터 유효성 확인 | 집계·서명 검증, 실패 시 미전달 |
| 평판 모듈 | 다차원 점수 갱신 | 운영 지표와 스테이킹 잔고 |
| 모니터링 모듈 | 응답 시간, 정확도, 온라인 여부 | 온체인 이벤트와 APM |
흐름은 단순합니다. 요청자가 등록한 뒤 요청 계약을 올리면 호출 계약이 평판·모니터링 상태와 함께 DQN을 돌립니다. 고른 노드가 외부 소스를 읽고 서명해 검증 계약에 넣습니다. 통과한 값만 요청자에게 돌아가고, 이번 수행으로 평판이 갱신됩니다. 중요한 설계는 선택이 온체인 루프에 묶여 있지 않다는 점입니다. 호출 계약이 모델을 로드한다고 적혀 있지만, 공개 구현은 이더리움 위에 계약을 두고 파이썬·TensorFlow 쪽 선택기를 Web3로 붙입니다.
다차원 신뢰
기본 평판은 신뢰도 점수, 행동 점수, 토큰 점수의 가중합입니다. 최종 평판은 여기에 시간 가중을 곱해 슬라이딩 윈도우에 쌓습니다.
| 차원 | 구성하는 값 | 논문 가중·설정 | 보는 질문 |
|---|---|---|---|
| 신뢰도 (reliability) | 상대 응답 빈도, 성공률, 평균 응답 시간. 성공은 마감 준수와 검증 통과가 동시에 성립할 때만 | 0.2 / 0.4 / 0.4 | 제시간에, 검증 가능한 값을 자주 주는가 |
| 행동 (behavior) | 안전·경미·중간·심각 위해. 횟수에 위해 점수를 곱함 | 위해 점수 0, 1, 5, 100 | 실수가 아니라 해로운 행동을 했는가 |
| 토큰 (token) | 해당 노드 스테이킹 / 커뮤니티 평균 | 기본 평판에서 0.2 | 틀렸을 때 잃을 돈이 평균보다 큰가 |
| 시간 (time factor) | tanh(χ/τ)를 기본 평판에 곱해 합산. χ = 0.6 | 윈도우 길이 5 | 옛 공적이 새 악행을 가리는가 |
기본 평판 가중은 신뢰도 0.4, 행동 0.4, 토큰 0.2입니다. 행동 항은 빼기입니다. 심각 위해 한 번이면 점수 100이 나가므로, 평판이 임계값 아래로 떨어지기 쉽게 설계되어 있습니다. 실험에서 임계값은 −1.5이며, 중간 위해를 한 번까지 허용하는 수준이라고 저자들이 밝힙니다.
슬라이딩 윈도우를 고친 이유가 이 논문의 실무적으로 가장 분명한 부분입니다. 일반 윈도우는 구간별 점수를 독립으로 둡니다. 짧으면 악행의 흔적이 금방 사라지고, 길면 체인에 쌓는 계산이 커집니다. TCO-DRL은 윈도우에 독립 점수가 아니라 시간 가중을 섞은 합성 점수를 넣습니다. 창은 5로 짧게 유지하면서, 한 번 한 악행이 오래 남게 합니다. 길이 1~10을 100구간 돌려 본 뒤, 너무 짧으면 신뢰 노드 간 구분이 약해지고 너무 길면 점수가 지수적으로 커져 5를 택했다고 합니다. 5는 만능 상수가 아니라 그 합성 데이터에 맞춘 하이퍼파라미터입니다.
DQN 선택
요청은 식별자, 도착 시각, 마감, 복잡도, 부가 서비스로 표현됩니다. 노드는 식별자, 평판, 요청당 비용, 처리 능력, 제공 서비스로 표현됩니다. 상태 공간은 요청 상태와 노드 상태의 합집합, 행동 공간은 커뮤니티의 노드 식별자입니다. 한 요청에 노드 하나를 고르는 문제입니다.
보상은 평판에 비례하고 비용에 반비례합니다. 요청의 부가 서비스와 노드 서비스가 다르면 벌점을 줍니다. 전체 응답 시간 대비 실제 수행 시간 비율을 넣어, 큐에서 오래 기다리게 만드는 선택을 불리하게 합니다. 학습은 표준 DQN입니다. 평가 네트워크와 타깃 네트워크, 경험 재생, ε-greedy입니다. 비교 실험의 재생 메모리 800, 미니배치 30, 학습률 0.01, 할인율 0.9입니다. 선행 분포 없이 환경과 상호작용한다는 점이 BLOR과의 차이로 강조됩니다.
| 항목 | BLOR | TCO-DRL |
|---|---|---|
| 신뢰 모델 | 평판 | 평판 |
| 평판 메트릭 | 성공·실패 횟수 | 신뢰도·행동·토큰 + 시간 |
| 실행 위치 | 온체인 | 온체인 / 오프체인 |
| 학습 | 사전 지식 있는 온라인 학습 (베이지안 MAB) | 사전 지식 없는 DQN |
| 시간 요소 | 없음 | 개선 슬라이딩 윈도우 |
| 서비스 매칭 | 없음 | 요청 조건과 노드 서비스 정합 |
| 공격 저항을 설계 목표로 명시 | 없음 | 있음 |
표의 학습·확장 항목은 저자 주장입니다. 아래 수치는 그 주장을 실험 조건 안에서만 받칩니다.
실험 결과, 그리고 시뮬레이션이 말하지 않는 것
공개된 오라클 데이터셋이 없어 저자들도 합성 데이터로 돌렸습니다. 비용 분포는 BLOR 쪽을 참고했고, 요청 복잡도와 노드 성능은 BandChain의 평균 응답 약 6초에 맞췄습니다. 도착은 포아송, 가격은 요청당 고정 요금입니다. 커뮤니티는 노드 15개, 서비스 유형 3종에 각 5개입니다. 요청 6,000건입니다. 비교용 커뮤니티에는 악의 노드 3, 양호(benign) 노드 3, 나머지를 신뢰 노드로 두었습니다. 비교 실험에서는 평판이 임계값 아래로 내려가도 선택을 막지 않았습니다. 탐지력을 보기 위한 설정이지, 운영 정책이 아닙니다.
비교 대상은 라운드로빈, BLOR, PSG입니다. BLOR은 초기 이력이 필요해 짧은 구간을 라운드로빈으로 채워 준 뒤 학습했습니다. 구현·재현 코드는 github.com/elpsylearning/TCO-DRL에 두 갈래로 있습니다. 베이스라인 비교용 파이썬과, 이더리움 배포용입니다. 공개 README 기준 환경은 Ubuntu 18.04, Geth 1.10.25, Truffle 5.5.32, Python 3.6.9, TensorFlow 2.0.0, Ganache-cli입니다. 계정은 ganache-cli -a 16으로 노드·처리자마다 하나씩 만듭니다. 실험 호스트는 Intel i5-7300HQ, RAM 8GB입니다.
| 지표 | 논문이 보고한 값 | 읽기 조건 |
|---|---|---|
| 악의 노드 할당 | TCO-DRL 4.28%. 다른 방법 대비 39.10%~78.58% 감소 | 15노드·6,000요청 합성, 비교 시 임계값 미적용. 39.10%는 하한입니다. |
| 신뢰 노드 할당 | 90.40%. 다른 방법 대비 15.27%~33.63% 증가 | 같은 설정. 양호 노드 할당은 오히려 더 적습니다. |
| 서비스 매칭 | 87.5% | 라운드로빈은 순번, BLOR은 해당 목적함수가 소스에 없음. |
| 평균 비용 (악의 3개일 때) | TCO-DRL 0.396. 라운드로빈 0.540, BLOR 0.518, PSG 0.450. 12.00%~26.67% 절감 | 고정 요금 가정의 상대 비용. 이더 가스나 원화 운영비가 아닙니다. |
| 악의 노드 9개일 때 할당 건수 | TCO-DRL 852. BLOR 1,342, PSG 1,118. 이론 평균 3,600 | 환경을 점점 나쁘게 만든 스트레스 테스트. |
| 이더리움 배포 지연 | 평균 트랜잭션 확인 지연 0.2초 미만 | Ganache/실험망. 메인넷 블록 시간과 다릅니다. |
공격 실험은 비교와 달리 임계값 −1.5를 켭니다. 참고한 분류는 IoT 신뢰 공격의 세 가지입니다.
- ME (malicious with everyone) — 누구에게나 낮은 품질을 줍니다. 평판이 임계값 아래로 빠르게 내려가 서비스가 막히고, 회복은 느립니다.
- OOA (on-off) — 착실한 구간과 배신 구간을 번갈아 탑니다. 같은 길이의 일반 윈도우에서는 3구간에 공격을 시작해 8구간이면 임계값을 회복합니다. 개선 윈도우에서는 32구간까지 회복이 미뤄집니다.
- OSA (opportunistic service) — 필요할 때만 잘해 점수를 올립니다. 한 번 해로운 행동을 하면 점수가 크게 떨어지고, 짧은 선행으로 신뢰 노드 수준까지 올리기는 어렵습니다. 임계값 위에 남을 수는 있으나 선택 확률은 낮아집니다.
노이즈(행동이 기댓값대로 나오지 않는 비율)를 키우면 모든 방법의 평균 응답 시간이 늘어납니다. 라운드로빈이 결정이 단순해 응답은 빠르고, BLOR은 고평판·저비용 노드에 몰려 대기와 비용 변동이 큽니다. TCO-DRL과 PSG의 비용 곡선은 상대적으로 평평합니다.
이 숫자들을 운영 DeFi나 금융 체인의 SLA로 옮기면 안 됩니다. 데이터는 합성이고, 노드 15개는 Chainlink 메인넷이나 국내 컨소시엄의 운영 규모가 아니며, 비용 단위는 실험용 상대값입니다. DQN은 탐험 구간에 나쁜 노드를 고를 수 있고, 보상 가중(ϑ=2.5, λ=1.5, μ=4)을 바꾸면 정책이 바뀝니다. TensorFlow 2.0·Python 3.6은 연구 스택입니다. 무엇보다 레이블이 있는 악의 노드가 실험자 손에 있습니다. 운영 중인 오라클 풀에는 그런 정답이 없습니다. 검증 계약이 무엇을 참으로 보는가 — 다수결인지, 외부 기준 가격인지, 서명 형식인지 — 가 모델보다 먼저입니다.
39.10%와 12.00%는 초록에 적힌 하한입니다. 제안서 한 줄로 옮기는 순간 실험 조건이 사라집니다.
한국 기업 블록체인 팀이 베낄 것과 베끼지 말 것
컨소시엄 체인, 자체 오라클, 공공 파일럿을 전제로 나눕니다. 카이아·넥스레저·하이퍼레저 계열은 이더리움 가스와 비용 함수가 다릅니다. 그 차이를 무시하고 DQN을 이식하는 것은 논문이 한 일이 아닙니다.
| 구분 | 내용 |
|---|---|
| 베낄 것 | 성공률 하나로 평판을 끝내지 말 것. 최근 창과 오래된 이력을 분리할 것. 등록·요청·선택·검증 계약을 나눌 것. 선택 로그와 평판 갱신을 감사 가능하게 남길 것. 스테이킹 또는 이행보증을 점수에 연결할 것. 요청 유형(주기, 정확도, 데이터 종류)과 노드 역량을 매칭할 것. 선택 계산은 오프체인, 결과와 증명은 온체인. 파라미터와 코드를 공개해 재현 가능하게 할 것. |
| 베끼지 말 것 | 솔리디티 안에서 DQN을 학습·추론하지 말 것. 39.10%·12%를 사업 수치로 쓰지 말 것. 운영 가격 피드(대출 청산, 외환, 담보 평가)를 자체 DRL 오라클로 교체하지 말 것. TEE를 붙였다고 입력을 신뢰하지 말 것. 윈도우 길이 5와 위해 점수 100을 검증 없이 상수로 두지 말 것. 레이블 없는 운영 로그에 강화학습을 바로 올리지 말 것. 개인정보·전자문서 증적이 필요한 업무에서 모델 보상보다 데이터 계보와 보관 의무를 앞세울 것. |
자체 오라클을 이미 운영 중이라면, 논문을 제품으로 보지 말고 점검표로 쓰는 편이 맞습니다. 노드별 성공률·지연·스테이킹·최근 N구간 사고 횟수가 한 화면에 있는가. 사고가 나도 평균에 묻히지 않는가. 고평판 노드 한곳에 요청이 몰려 대기와 단일 장애가 생기지 않는가. 선택 이유가 사후에 설명되는가. 이 네 가지가 없으면 DQN을 올리기 전 단계입니다.
보안 설계 관점에서는 보상 함수가 곧 공격면입니다. 토큰 점수 비중이 높으면 자본이 평판을 삽니다. 다수결만 보면 담합이 진실이 됩니다. 최근 창만 보면 장기간 잠복 후 한 방이 쉬워지고, 오래된 이력만 보면 배신 반응이 느려집니다. TCO-DRL은 그 트레이드오프를 가중치로 드러낸 것이 기여입니다. 가중치를 숨긴 채 “AI가 최적 노드를 고른다”고 쓰면, 심사와 장애 분석에서 설명이 사라집니다.
Takeaway
- 체인 합의는 오라클이 넣은 값을 합의할 뿐, 그 값이 현실과 같다는 뜻은 아닙니다.
- TEE는 실행 환경을, 평판은 과거 이력을 봅니다. 둘 다 최근 배신과 비용을 동시에 풀지 못합니다.
- TCO-DRL의 실무적 핵은 DQN 자체보다 신뢰도·행동·스테이킹·시간 창을 나눈 평판과, 선택·검증을 계약으로 나눈 구조입니다.
- 악의 할당 4.28%(대비 최소 39.10% 감소)와 비용 최소 12% 절감은 노드 15개·요청 6,000건 합성 실험의 하한입니다. 운영 DeFi SLA가 아닙니다.
- 개선 윈도우는 on-off 회복을 5구간에서 32구간으로 미룹니다. 창 길이 5는 그 데이터에 맞춘 값입니다.
- 한국 기업 팀은 다차원 평판과 오프체인 선택을 참고하고, 실험 수치와 온체인 DQN과 자체 가격 피드 교체는 가져가지 않는 편이 안전합니다.
참고문헌
H. Zhang, S. Li, H. Bao, S. Wu, and J. Li, “A Trust-Aware and Cost-Optimized Blockchain Oracle Selection Model with Deep Reinforcement Learning,” arXiv:2502.16133, Feb. 2025. https://arxiv.org/abs/2502.16133
구현 코드: https://github.com/elpsylearning/TCO-DRL
비교 대상으로 인용된 BLOR은 베이지안 다중팔 도적 기반 오라클 선택 모형이며, TCO-DRL 본문 Table I 및 관련 연구 [13]을 따릅니다. 공격 유형 ME·OOA·OSA는 Marche and Nitti, “Trust-related attacks and their detection: A trust management model for the social IoT,” IEEE TNSM, 2020을 오라클 실험에 옮긴 것입니다.
실무 배포 시 추가로 점검할 것
DQN 기반 오라클 선택기를 논문 환경에서 실제 프로덕션으로 옮길 때, 논문이 다루지 않는 운영 리스크가 남는다.
- 콜드 스타트 문제: DQN은 충분한 에피소드를 거쳐야 정책이 수렴한다. 신규 배포 직후, 즉 학습 데이터가 부족한 구간에는 규칙 기반(예: 평판 점수 상위 N개 단순 다수결) 폴백을 병행해야 한다. 강화학습 정책만 단독으로 콜드 스타트 구간에 노출시키면 초기 선택 오류가 온체인에 그대로 기록된다.
- 보상 함수의 게이밍 가능성: 오라클 노드가 보상 함수의 형태를 추정할 수 있다면(예: 정확도와 응답 속도에 가중치가 있다는 것을 알면), 평가 구간에서만 정직하게 응답하고 그 외에는 편향된 값을 제출하는 전략적 행동이 가능하다. 평가 시점을 노드가 예측할 수 없도록 무작위화하는 것이 최소 방어선이다.
- 정책 감사 가능성: DQN의 의사결정은 신경망 가중치로 인코딩되어 사람이 직접 검증하기 어렵다. 규제·감사 요구가 있는 도메인(금융, 헬스케어)에서는 선택 결과에 대한 사후 설명(예: SHAP 값 기반 특성 기여도)을 별도로 로깅해 두어야 분쟁 시 근거를 제시할 수 있다.